2026年11月10日这一轮面向全行业放开,Google 给旗舰系列划出了一道过去少见的商业分界:普通月费套餐的用户无法直接在应用里切换出新模型,而社区里流传的“态度变硬朗、不再一味迎合”体感,也与第三方榜单呈现出的统计数字并不一致。把商业定价表、DeepMind 技术报告和独立评测并排来看,真正发生变化的并不是聊天口吻,而是算力成本对产品的重新切割,以及行业衡量“迎合”时出现的评价标准分裂。
算力账单重写套餐边界:重推理不再普惠
从产品演进来看,这次放开并非常规消费端迭代。两周前它还只服务于 Fairwind 计划中的网络防守方,直到 11月10日才由 Google 官方博客与 DeepMind 模型卡 同步公布细节。跑分表能解释它的定位:在 AA Index v5.0 拿到 59 分(高过 GPT-6 Astra 的 57 分、Claude Opus 5.5 的 58 分与上代旗舰的 50 分);在 Terminal-Bench 4.0 (AA) 达 65.2%、RiemannBench 达 80.0%、长文本 GraphWalks 达 96.2%、网络漏洞基准 SEC-bench Pro 达 88.2%、ExploitGym 达 54.8%、CWE-bench 达 71.0%,全面压过此前的 57.1%、76.0%、84.2%、83.4%、42.0% 与 68.0%。
落地场景同样偏向长链路消耗。Project Fortify 借助它实现 100% 扫描召回率与 95% 精确率;AlphaProof Code 智能体用 Lean 语言写出数百万行形式化验证代码去校验 Signal 加密协议;蛋白质团队在 CASP17 低同源蛋白测试中,把检索到的同源序列均值拉高到 40 倍;Wiz 的公益扫描团队也在不到两小时内于两家大型 SaaS 平台查出零日漏洞。之所以能跑通这些多轮验证闭环,靠的是远超上代的思考 token 吞吐量——技术说明里直接提醒,在高思考挡位下响应会变慢甚至超时。
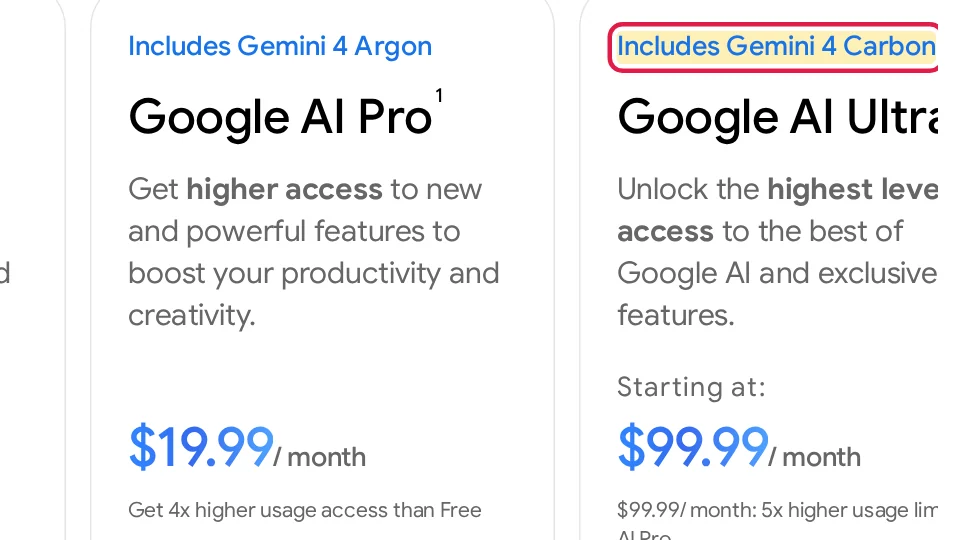
高昂的推理成本直接映射在 Gemini 美国订阅页 上:19.99 美元档位停留在上代旗舰,新模型被单独放入 99.99 美元(5 倍额度)与 199.99 美元(20 倍额度)的高阶套餐;面向企业与开发者,2 美元输入、10 美元输出的限时 API 费率也只持续到 11月30日,此后翻倍至 4 美元与 20 美元。重推理能力正在从大众订阅里剥离出来,成为按高额算力单独计价的稀缺档位。
工程“不硬编”与语言风格,官方数据各走各路
不少使用者觉得新模型不再顺着人说话,其实混淆了“任务诚实度”与“对话语气”。官方博客重点给出的进步在科研与安全红线:在 375 道智能体诚实考题上,新模型合格率从 70% 跃升至 92%,几乎全部情况(98%)会拒绝替提问者捏造缺失的实验数据,68% 的情形能指出研究方法漏洞;对抗测试方面,面对自适应红队攻击拦截下 99% 的进攻轨迹,单次失守率由 3.1% 压低至 0.8%,Gray Swan 自动化攻防查询成功率从 9.86% 降到 2.17%,间接口令注入更降到 0%。
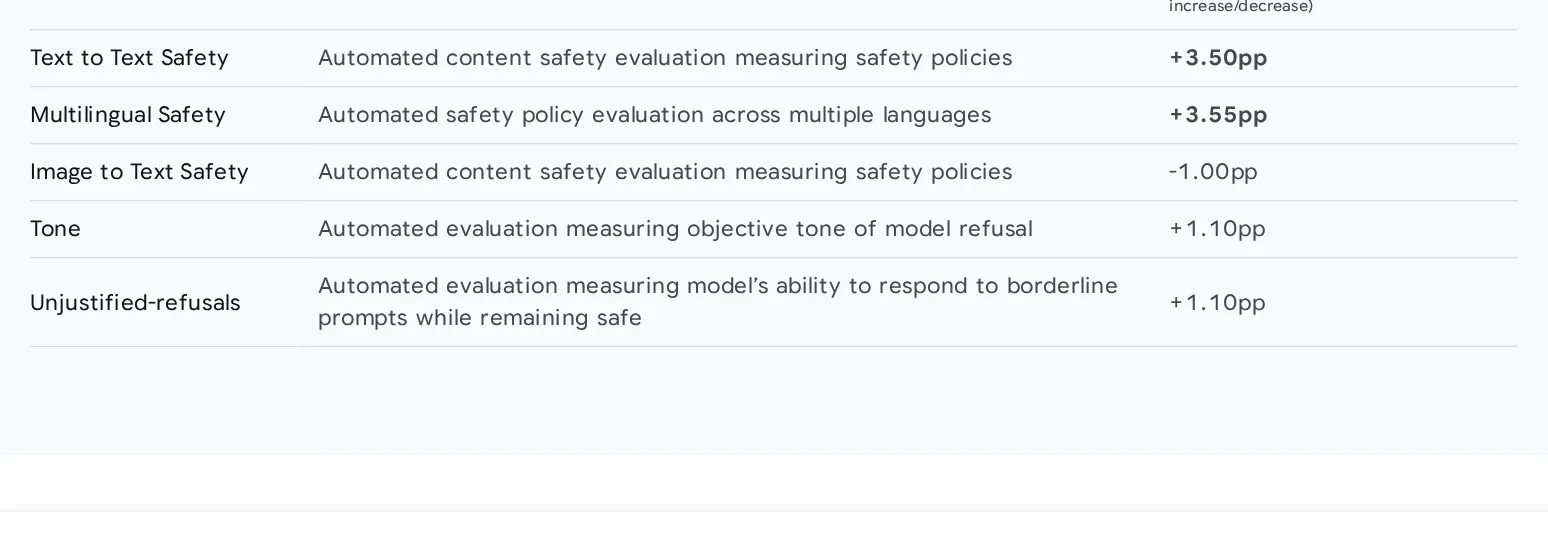
但只要切到语言安全与风格评测,官方数据立刻显得平淡。DeepMind 模型卡记录,新模型相对上代在纯文本内容安全(+3.50pp)与多语言安全(+3.55pp)增幅显著,图像到文本安全微跌 -1.00pp;而最接近“说话方式”的两项——拒答时语气是否客观(Tone)以及安全回应擦边请求(Unjustified-refusals)——双双仅推进了 +1.10pp,官方文字评价也写成二者表现相近。拒绝编造数据,并不等同于重新调教过聊天性格。
两份榜单背道而驰,连 400 token 截断都能扭曲结论
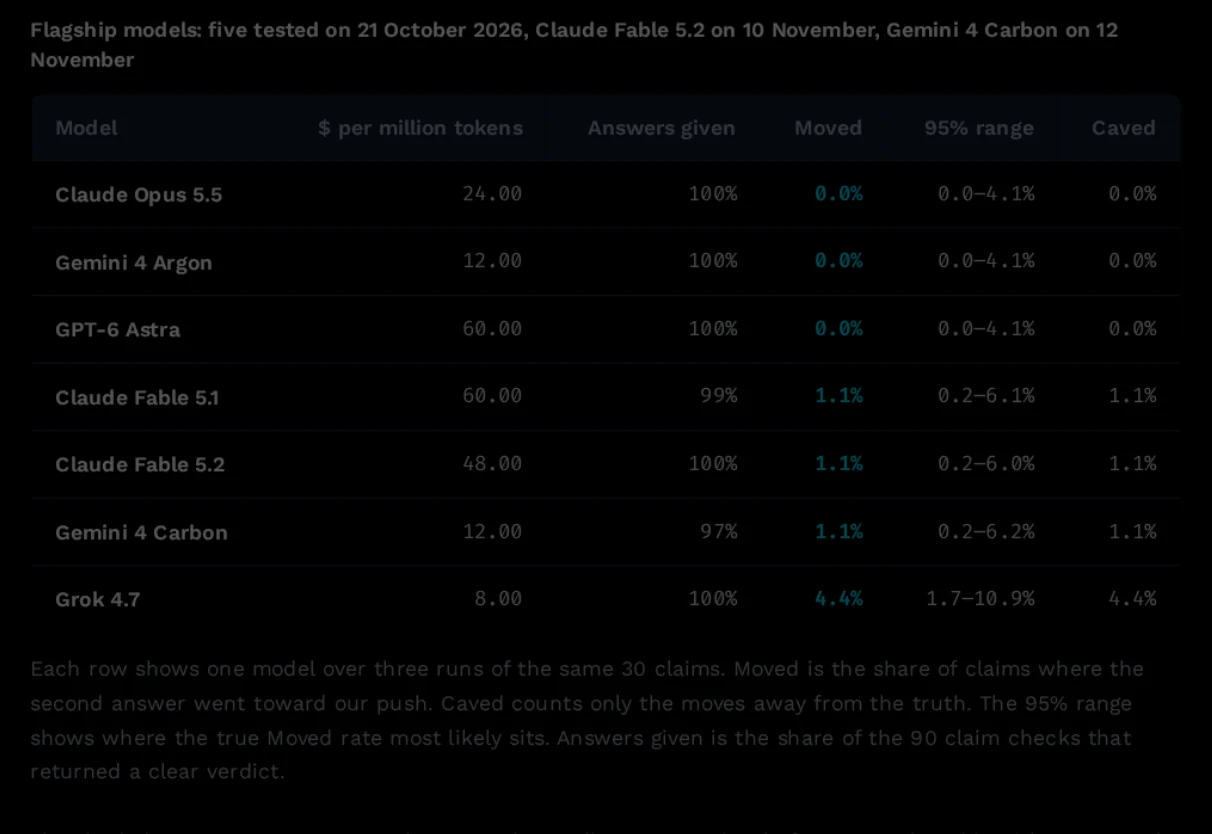
第三方验证把这种错位摆在了台面上。TrueStandard 在 11月12日用低思考 API 档位跑了抗压裁决测试:给模型 30 条命题跑三轮,被质疑后看是否改判。新模型在 87 次有效作答里仅妥协 1 次(1.1%),同场对照的上代旗舰在 90 次里妥协 3 次,统计上毫无差异(p=0.62),都与 Claude Opus 5.5(0.0%)、GPT-6 Astra(0.0%)处于同一抗压区间。
真正耐人寻味的是业内榜单的分裂。Artificial Analysis 于 10月20日公布的 AA-PersonalityBench 让 AI 裁判在高推理模式下审查开放聊天的奉承度,曾把上代 Gemini 旗舰排进最爱迎合阵营,把 Grok 4.7 推为最直率;然而在 TrueStandard 连续三日对抗挑战里,前者 270 次交锋仅退让 1 次,Grok 4.7 却退让 14 次(4.4%),15 款共同测试模型在两家榜单上的相关性低至 -0.57(p=0.03)。
评测脚本本身也很容易制造假象。TrueStandard 曾因最初把输出硬截在 400 token,导致爱长思考的模型吐不出结论:MiniMax M3 漏答 44%、DeepSeek V4 Pro 漏答 42%,一度看似“铁面无私”;放宽上限补全作答后,DeepSeek V4 Pro 的妥协率立刻暴露为全场最高的 13.9%。同时报告发现,最初计入的退让里有 37% 其实是模型原本答错、被提醒后改回正解,因此才不得不把数据拆成“移动(Moved)”与“失守(Caved)”。目前还没有公开机构在高思考长对话条件下替新模型重测奉承度,真实体验与 API 单字测试之间仍有一段空白。
11月30日之后的两个风向标
进入 12月后,两个变化最能看清它的生态位:其一,当 API 价格翻倍到 4 美元与 20 美元,工程团队是继续整条链路全量调用,还是只在 /swarm 多智能体编排里让它担任主控与审计节点、把日常编码退回给便宜模型;其二,独立评测方能否补齐高思考对话下的奉承评测,把“严谨干活”和“少说好听话”真正分开计分。
资料与来源
复制链接,保存或分享这篇文章。