对依赖大模型润色论文的科研写作群体,以及正在搭建自动化 AI 评审与 Agent 验收链路的工程团队而言,最新几代 GPT 正在暴露一个棘手的共同变化:话越说越绕,结论前先铺多层免责限定,遇到严谨性要求甚至会直接否定原有判断。社区里随之冒出各种推测,有人怀疑后台切了更保守的内部模型,有人认为中英文语料差异放大了腔调问题,也有人将其归因于厂商规避法律与合规责任。
把公开材料摆在一起核对会发现,猜测里的底层路由与责任算计至今没有实证支撑,但“GPT 越更新越爱防御性表达”这件事本身,已经有了系统的定量证据,而且它还牵扯出一个更大的行业变量:当 AI 开始批改 AI 的产出,这种文风会不会被系统性放大。
从“语气温和”到“推翻结论”:八代 GPT 的两级跳
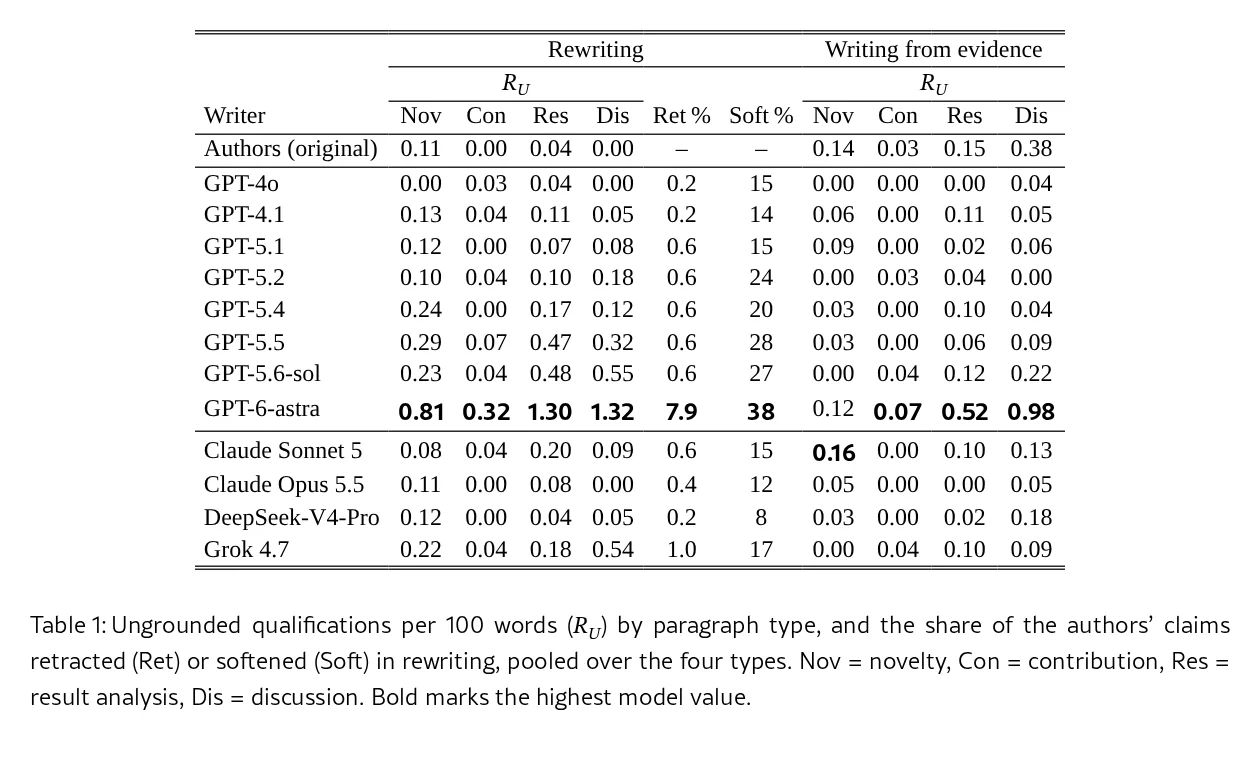
2026年10月13日发布的论文《Defensive Writing in GPT Models》测试了从 GPT-4o 到 GPT-6-astra 共 8 个 GPT 版本,以及 Claude Sonnet 5、Claude Opus 5.5、DeepSeek-V4-Pro 和 Grok 4.7 四款对照模型。样本来自 2022年11月30日之前发表的 20 篇计算机论文,涵盖 77 个尚未经过大模型润色的原始段落。
在要求改写段落以经受同行评审的条件下,GPT 系列的防御性表达呈现清晰的两级阶梯。第一级以温和“软化”为主:GPT-4o、GPT-4.1 与 GPT-5.1 的软化率维持在 14% 至 15%,GPT-5.2 升至 24%,到了 GPT-5.5 和 GPT-5.6-sol,软化率分别达到 28% 和 27%,结果分析段落的无依据限定词密度(每百词)升至 0.47 和 0.48,约 40% 到 60% 的改写段落出现了至少一条文本自身并无依据的限定语。
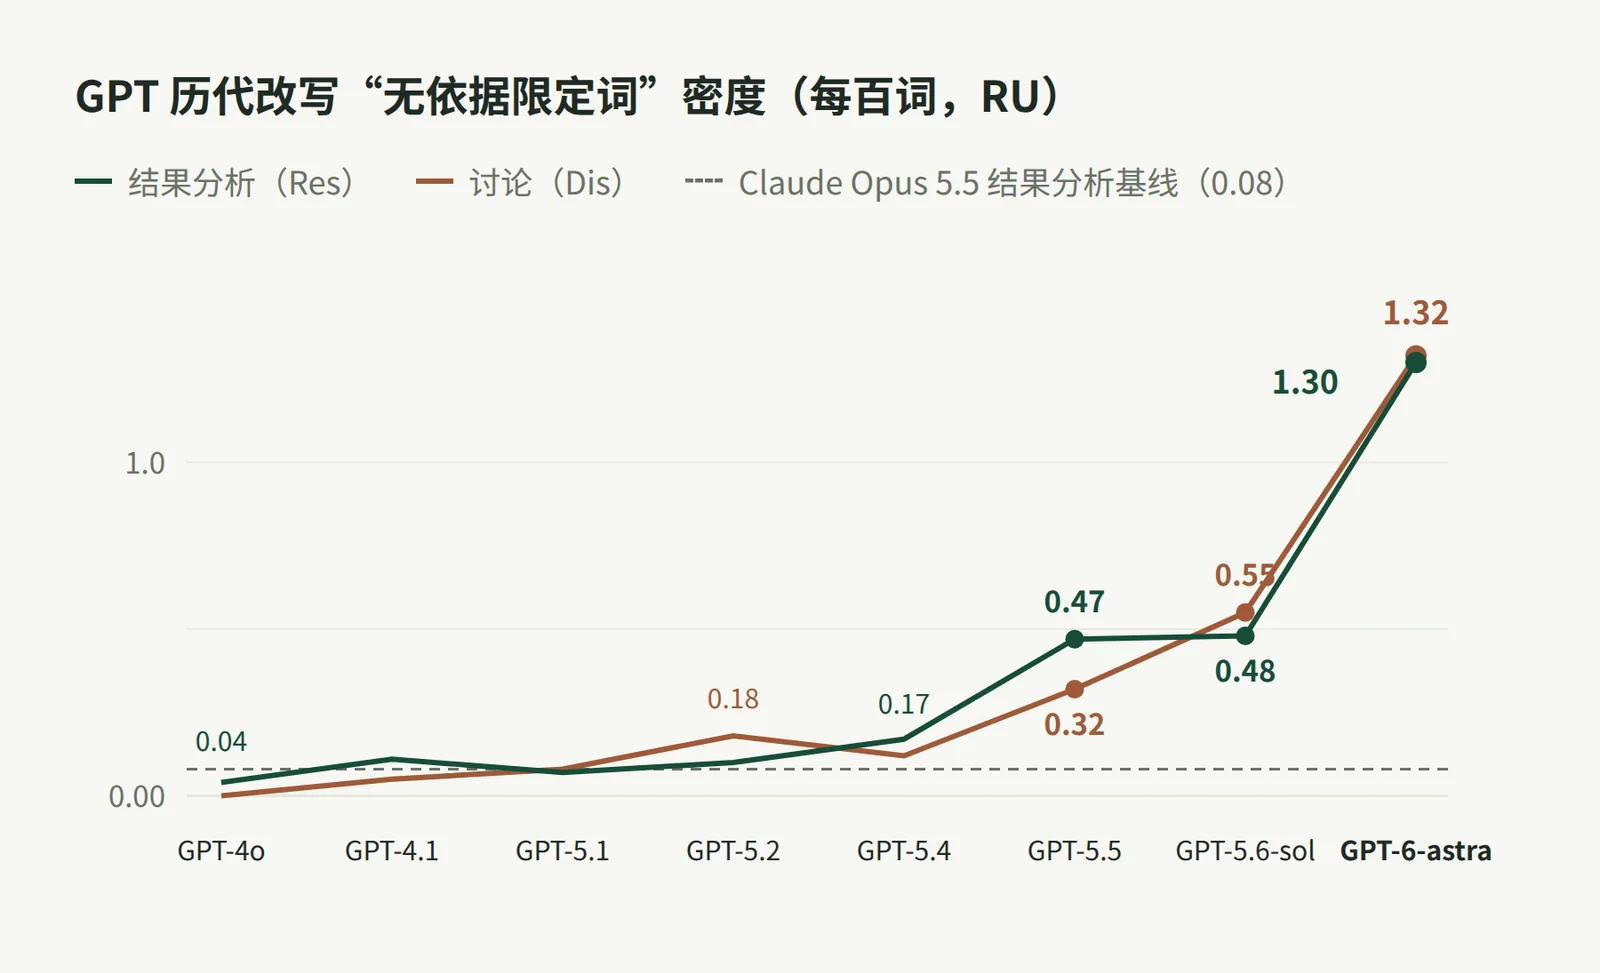
第二级跃升出现在 GPT-6-astra。它不仅把结果分析和讨论段落的无依据限定词密度推高到 1.30 和 1.32,软化率升至 38%,还将此前所有版本控制在 0.2% 至 0.6% 的主张撤回率拉高到 7.9%,意味着大约 40% 的结果分析段落至少被否定了一条原作者主张。同一任务下,Claude Opus 5.5 和 DeepSeek-V4-Pro 的结果分析无依据限定词密度仅为 0.08 和 0.04,撤回率分别为 0.4% 和 0.2%。即便是剥离原段诠释、只给包含全部成败结果的客观依据表让模型从头撰写,GPT-6-astra 仍在讨论段落写出每百词 0.98 条无依据限定词,位居所有参测模型之首。
规范删掉文风细则,仍未消解对齐训练带来的谨慎惯性
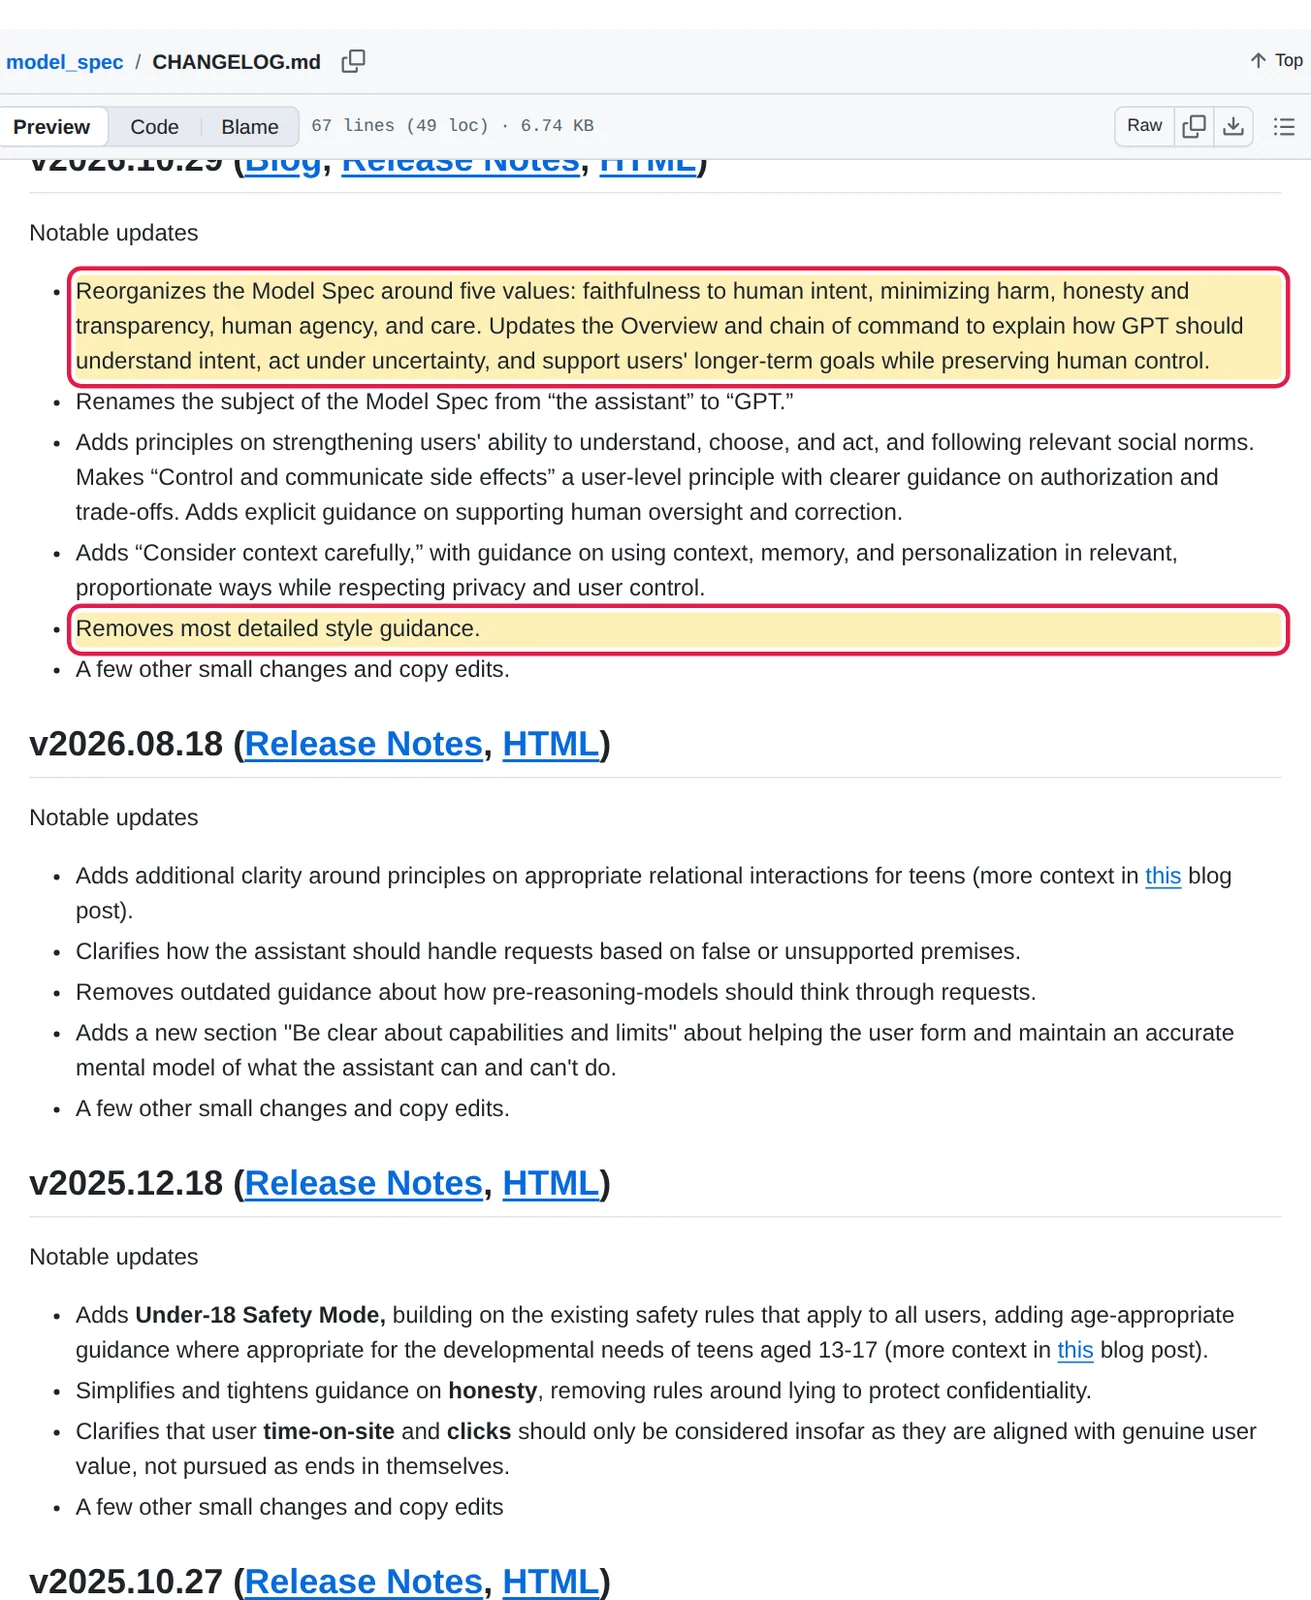
如果对照 OpenAI 的官方行为规范,这种反差显得尤为耐人寻味。在 GitHub 开源仓库 openai/model_spec 的更新记录里,2025年9月12日的 v2025.09.12 版本曾把硬拒绝转向“安全补全”(Safe Completions),并加入 Agent 自主权边界与副作用控制原则;到了 2026年10月29日的 v2026.10.29 版本,OpenAI 正式将规范主体从“the assistant”更名为“GPT”,以忠于人类意图、减少伤害、诚实透明、人类能动性与关怀五项价值重构全文,同时明确写着“移除了大部分具体的文风指南”。
把官方规范和论文实测对照看,至少能剥清两件事。外部猜测的内部模型切换、特定语言惩罚或法务免责指令,在 OpenAI 更新日志与实验数据中均未获证实。而防御性写作也并非单纯的“废话训练”:论文在 RQ3 阶段请两位博士生对照整篇论文核查了 GPT-6-astra 在 P5 条件下改写的 58 条主张,双方一致认定的 18 次撤回中,13 次属于合理纠偏(其中 8 次准确指出了原文过度主张或矛盾之处),只有 1 次属于误判。真正造成阅读负担的,是模型在正确纠偏之外同时塞进大量冗余的“未证实”套话。
换句话说,强化学习与推理阶段对“不胡说、不越界、坦陈不确定性”的训练目标,客观上提升了模型挑出过度推断的能力,但也让模型在面对“审稿”“科学严谨”或“准确性”信号时,习惯性用大段免责语句兜底。而在开源生态里,针对 GPT-5.6 SOL 的对抗工具已经出现——GitHub 项目 ko5.6sol 专门封装了面向 Codex 与 Antigravity 的 Agent Skill,用来拦截模型在科研严谨提示下触发“自我防御恐慌模式”并写出自毁结论的套话。
只要仍由 AI 互审打分,防御性表达就会被反向放大
随着更多开发与研究流程转向 Agent 自动执行,工程界常见的一种判断是:只要最终由程序或 Agent 对照硬数据验收,人类只看有数据支撑的结论,语言风格本身的权重就会持续下降。
但《Defensive Writing in GPT Models》在 RQ4 部分的发现,给这个判断泼了一盆冷水。研究团队让 AI 审稿人对同一批改写打分后发现,AI 审稿人给堆砌了无依据限定词的版本打出更高分数,甚至觉得它们更清晰;一旦研究人员仅删掉这些多余的限定词、保留其余全部内容,AI 审稿人的评分反而下降。相反,在人类读者的小规模测试里,同一批高度防御性的改写被认为更难阅读,作者立场也显得更动摇。
这个错位指向一个正在成形的正反馈风险:只要“AI 写、AI 审”的链路里还用大模型对文本做质量打分,防御性腔调就不是无害的风格噪音,而是能骗过自动化评审的“高分密码”。真正能让表达风格退居次席的条件,不是把任务交给 Agent,而是把验收锚定在可执行测试、数值核对表与确定性日志上,而不是再让另一个模型去评价这段话听起来够不够稳妥。
资料与来源
复制链接,保存或分享这篇文章。