
Humata
效率办公通过带来源的回答检索、总结和比较上传文档。Humata 提供团队文档访问功能,并以页数额度支持持续知识工作。
跨文件提问引用段落
免费自部署的 RAG 知识平台,重视文档解析、可检查的检索过程和带来源的回答,可将复杂资料接入聊天与应用。
RAGFlow 适合“先从资料里找到正确内容,再回答问题”的工作。它将文件解析成可检索片段,允许查看这些片段,并把相关结果交给语言模型。对产品手册、报告、演示文稿和结构较复杂的资料,比单纯把整段文字复制进聊天框更容易检查信息究竟来自哪里。
这种方式称为检索增强生成,也就是 RAG。模型回答时取得选中的文档上下文,并不是每上传一份文件就永久重新训练一次。来源引用有助于追溯,却不保证结论完全正确;模型仍可能漏掉例外条件或误解表格,所以必须能够回到原文检查。
技术手册查询
多份报告对照
内部流程查询
排查知识库遗漏
官方图片,可点击放大查看。
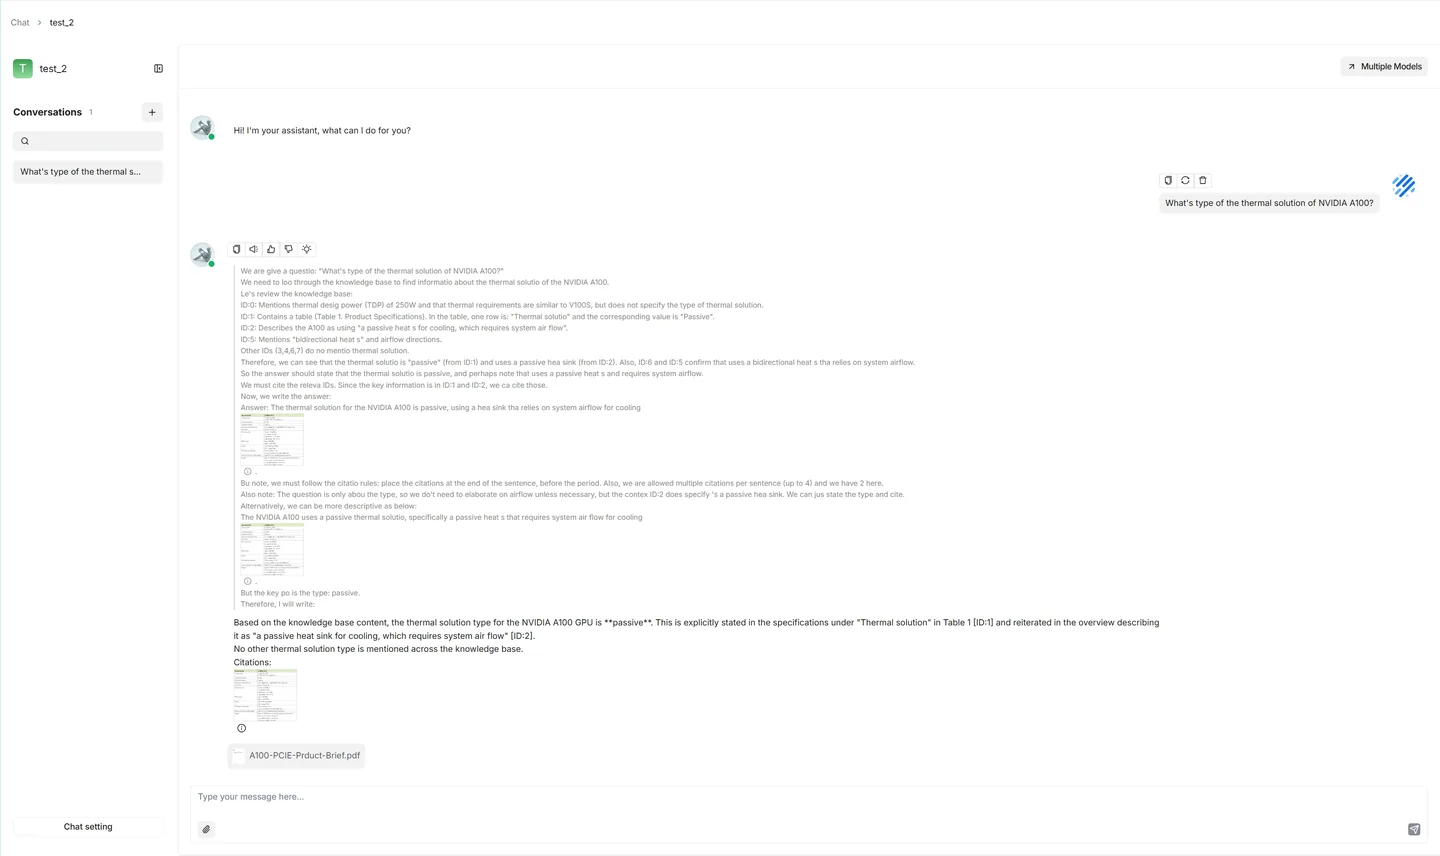
选择匹配的发行版部署
配置模型并建立资料集
解析一份代表性文件
创建有边界的问答助手
示例提示或操作任务:只依据所选手册,说明支持的运行条件和例外情况,每一点附对应原文片段。如果检索资料不足以回答,请明确写“当前资料集中未找到”,不要依靠常识补充设备参数。
这是编辑建议的边界检查任务。明确缺失信息的响应并核对原文,比看到引用标记后就认定系统不可能产生幻觉更有实际价值。
软件按许可免费部署,解析、存储和推理仍需要资源。
项目采用 Apache-2.0,提供无需软件订阅的自部署路径。服务器、数据库或文档引擎、文件存储、解析任务与模型请求仍需要资源。本地推理可以避免外部 API 账单,但会增加自己设备承担的计算与内存压力。
当前快速入门给出的起始建议为四核 x86-64 CPU、16 GB 内存和 50 GB 可用磁盘。这是应用起步参考,不是所有工作负载的保证;本地模型、大量文档与多人并发可能需要明显更多资源,实际部署应结合处理量评估。
Apache-2.0 项目可免费自部署;基础设施和模型服务费用另计,不能把软件免费等同于整套系统完全没有成本。
通常不是。正常路径是检索相关片段后交给模型作为上下文,与永久修改模型权重是不同的工作。
可能是分块、召回、资料集选择或模型理解有误。引用标记只说明指向哪里,并不证明该段内容支持最终结论。
指南对此有限制,不同嵌入空间不能混用。更换前应安排迁移或重新索引,避免破坏原有检索一致性。
支持本地模型服务等路径,不一定需要付费云端 API;但本地运行仍需兼容模型和足够硬件。
设置明确的未找到响应。任由助手自由补充,可能得到超出资料依据的说法,不适合严格的制度或手册查询。
官方提供 HTTP API。应配置对应应用权限,并验证来源引用、错误处理和资料访问边界是否正确传递。
平台、输入输出、开源许可和使用条件,完整保留在这里。
当前仓库快速入门介绍 Go 部署路径,原生 Docker 目标为受支持的 Linux x86-64 平台。版本说明会变化,使用时应把文档、镜像和数据库版本对应起来,不直接将最新开发分支的步骤套在较旧环境上。
支持的输入包括常见文档、表格、图片和幻灯片,实际解析效果仍受文件结构影响。指南特别说明,资料集已经使用某个嵌入模型解析后,不能随意直接更换,因为不同向量空间不可直接比较。计划换模型时,应考虑重新索引或创建独立资料集。
自行部署可以控制应用和文件的存储位置,但外部嵌入、聊天或解析服务仍可能收到处理所需材料。认定完全本地前,应检查整条链路,而不是只看网页运行在哪台服务器。
保留资料原件,同时备份配置和知识数据。软件许可并不赋予对外分享保密文件的权利,接口集成也应避免把本来私有的资料集变成未经预期的公开内容。
正在加载使用体验…
收藏仅自己可见。评论通过审核后公开,修改后会重新审核;评论数量包含获准公开的评论和回复。每人一份评分,新评分自动批准,撤回、未获批准或失效的评分不计入总分。请分享真实体验,避免垃圾信息、私人信息或人身攻击。
审核申诉或数据处理问题: support@findgoodai.com
带上一个真实任务,看看它是否适合你的工作方式。
使用体验