
Humata
效率办公通过带来源的回答检索、总结和比较上传文档。Humata 提供团队文档访问功能,并以页数额度支持持续知识工作。
跨文件提问引用段落
免费开源文字识别与文档解析工具包,将图片、扫描件和 PDF 转为可检索文字及结构化数据,适合开发者建设知识库和自动化流程。
PaddleOCR 帮助开发者把扫描页和图片文字变成机器可以处理的信息,既提供文字识别,也提供更完整的文档结构解析。项目可以从简单 OCR 开始,再逐步搭建保留版面和表格的处理流程。它首先是需要集成的软件工具包,而不是所有用户都获得相同上传额度的在线网站。
选择工具时,应先明确最终需要什么结构。搜索归档可能需要文字行及位置,知识库需要段落和阅读顺序,表格流程则需要正确对应行列的单元格。识别出了每个字,并不代表已经正确还原文档逻辑,所以产线选择应由实际输出需求决定。
扫描资料检索
知识库资料准备
表格数据采集
多语言图片识别
官方图片,可点击放大查看。
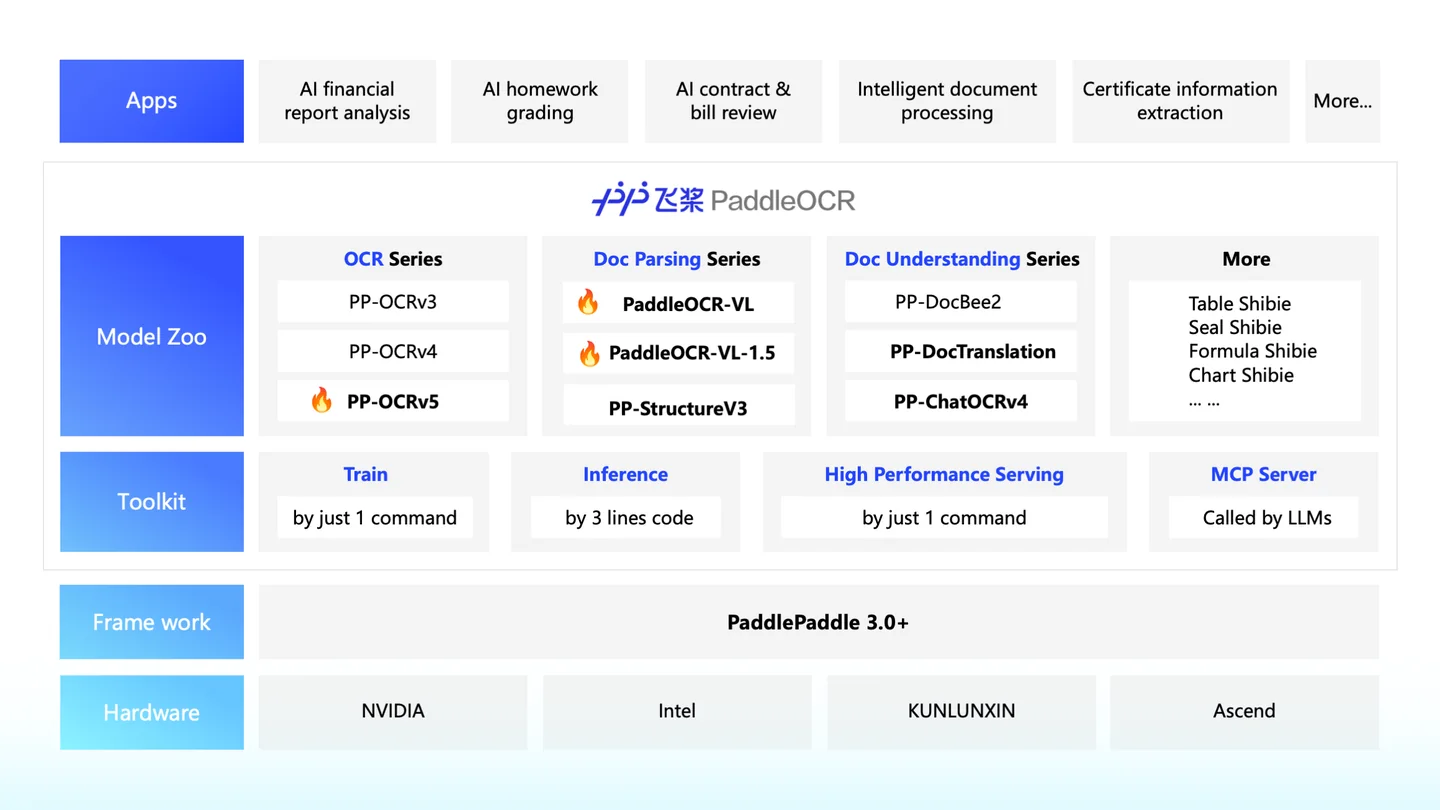
明确输出目标
安装匹配环境
本地运行小样本
核对后再扩大规模
示例提示或操作任务:选择一页含表格的双栏 PDF,提取结构化结果,对照原图检查阅读顺序,逐个核对表头和单位,再把确认后的内容加入可搜索知识库。
这是建议的处理任务,并不表示工具默认提供聊天式提示词界面。实际命令、模型名称和参数应以安装版本对应的产线文档为准。
免费路径指本地软件;托管 API 额度及可选大模型服务遵循各自条款。
Apache-2.0 工具包提供免费本地路径,由自己准备设备并运行支持的软件和模型,不要求为这条路径购买云端按页服务。不过处理时间、模型存储、部署维护及租用硬件仍属于实际成本,应结合批量文档规模评估。
托管 API 和可选大模型集成属于其他服务。OCR 提取也不自动附带无限量付费模型调用,摘要、语义理解或文档对话需要单独选择组件。
Apache-2.0 本地工具包提供免费使用路径,计算、存储、可选托管 API 和外部模型服务另外承担。
主要是面向开发者的工具包,提供 Python 与命令行流程。可以围绕它开发应用,但它本身不等同于完整托管文档聊天产品。
不是,语言范围属于具体模型或产线。应核对所选模型,并先测试实际混合语言样本,再处理整个资料集合。
文档解析产线支持表格结构,但复杂边框、合并单元格和低质量扫描仍可能导致错误,需要与原页对照。
不能,置信度是模型信号,不是独立验证。姓名、编号、日期和重要数值仍应回看原始文件。
需要先核对版本。项目存在跨大版本接口变化,当前文档和旧代码片段不能默认互换。
基本本地 OCR 并不天然要求付费云模型。额外语义提取、摘要或聊天流程可能引入其他组件和费用。
平台、输入输出、开源许可和使用条件,完整保留在这里。
安装涉及推理引擎和适当的软件包组件。快速开始提供不同引擎路径,但并非所有模型和功能在各个后端上都完全相同,应同时核对产线、后端、包版本与硬件,不直接把旧教程命令复制到新环境。
通过文档说明的产线可以处理图片和 PDF 等输入。超大页面、倾斜扫描、严重压缩的小字及复杂表格需要单独验证。无人值守运行时,为每份输入设置稳定编号并记录失败项,避免部分完成的任务在界面上被误认为完整归档。
本地部署可以让文档处理保持在自己的环境内,但模型下载和主动选择的远程接口仍属于独立联网活动。增加托管服务时,应检查文件与结果究竟在哪里保存和处理。
代码许可不代表获得任意文档的处理与再发布权。使用适当来源的材料,保留原件方便核对;识别后的文本可能包含与扫描件相同的信息,也应按照对应资料要求管理。
正在加载使用体验…
收藏仅自己可见。评论通过审核后公开,修改后会重新审核;评论数量包含获准公开的评论和回复。每人一份评分,新评分自动批准,撤回、未获批准或失效的评分不计入总分。请分享真实体验,避免垃圾信息、私人信息或人身攻击。
审核申诉或数据处理问题: support@findgoodai.com
带上一个真实任务,看看它是否适合你的工作方式。
使用体验