
GPT-6 Astra 是 OpenAI 面向高难度工作的推理模型,正式 API 名称为 gpt-6-astra。它把复杂推理、代码修改、研究与工具使用放在同一个工作流中:先理解问题,查阅材料,执行可用工具,再根据结果调整下一步。对使用者来说,值得关注的是一个任务能否完整交付,例如从定位软件故障一直做到修改代码和验证结果,或者从收集资料一直做到一份能够使用的报告。
先看清模型规格与使用边界
官方模型页列出 1,050,000 token 上下文窗口、922,000 token 最大输入和 128,000 token 最大输出,知识截止日期为 2026 年 4 月 30 日。输入支持文字与图像,模型直接输出文字。图像输入意味着可以让它阅读截图、界面或图表;生成图片则需要配置相应的图片生成工具,不能把两件事混在一起。
长上下文适合放入多份有相互关系的资料,例如需求说明、模块代码、日志与旧版设计文档。实际使用仍应组织材料:标清文件名与日期,指出最新版本,把必须遵守的条件放在明确位置。资料能放进去,不等于每一段都会得到同样可靠的处理;关键数字、引用和最终成果还需要核对。
| 项目 | 核对结果 |
|---|---|
| API 模型 ID | gpt-6-astra |
| 输入 / 输出 | 文字、图像输入 / 文字输出 |
| 推理强度 | low、medium、high、xhigh、max |
| 接口 | Responses、Chat Completions、Batch;工具调用使用 Responses |
| 常用能力 | 流式输出、结构化输出、函数调用、搜索、提示缓存 |
哪些工作更适合交给 Astra
第一类是线索分散的代码工作。把报错、复现步骤和相关代码一起交给模型,让它先定位原因,再提出一个范围明确的修复,最后列出验证结果。对于跨多个模块的问题,任务说明应包括哪些接口不能改变、哪些数据必须保留,以及怎样才算修好了。只让模型“优化代码”,很容易得到许多看似积极但难以验收的修改。
第二类是需要反复核对材料的研究和文档工作。例如比较供应商方案时,可以要求它在同一张表里列出价格口径、部署方式、资料日期、缺失信息和对应链接,然后再根据预算与使用量作判断。把自己的选择条件写进去,比笼统地要求一份“专业分析”更有帮助。
第三类是跨应用操作。模型页列出电脑操作、浏览器搜索、代码执行、托管 Shell 和 MCP 等工具支持,但这些能力取决于应用实际接入的工具与权限。在 Codex 或 Work 中能否浏览网页、修改文件、访问账户,要看当前环境;单独调用一个文本 API,并不会自动得到桌面控制能力。
工具调用的一次完整往返
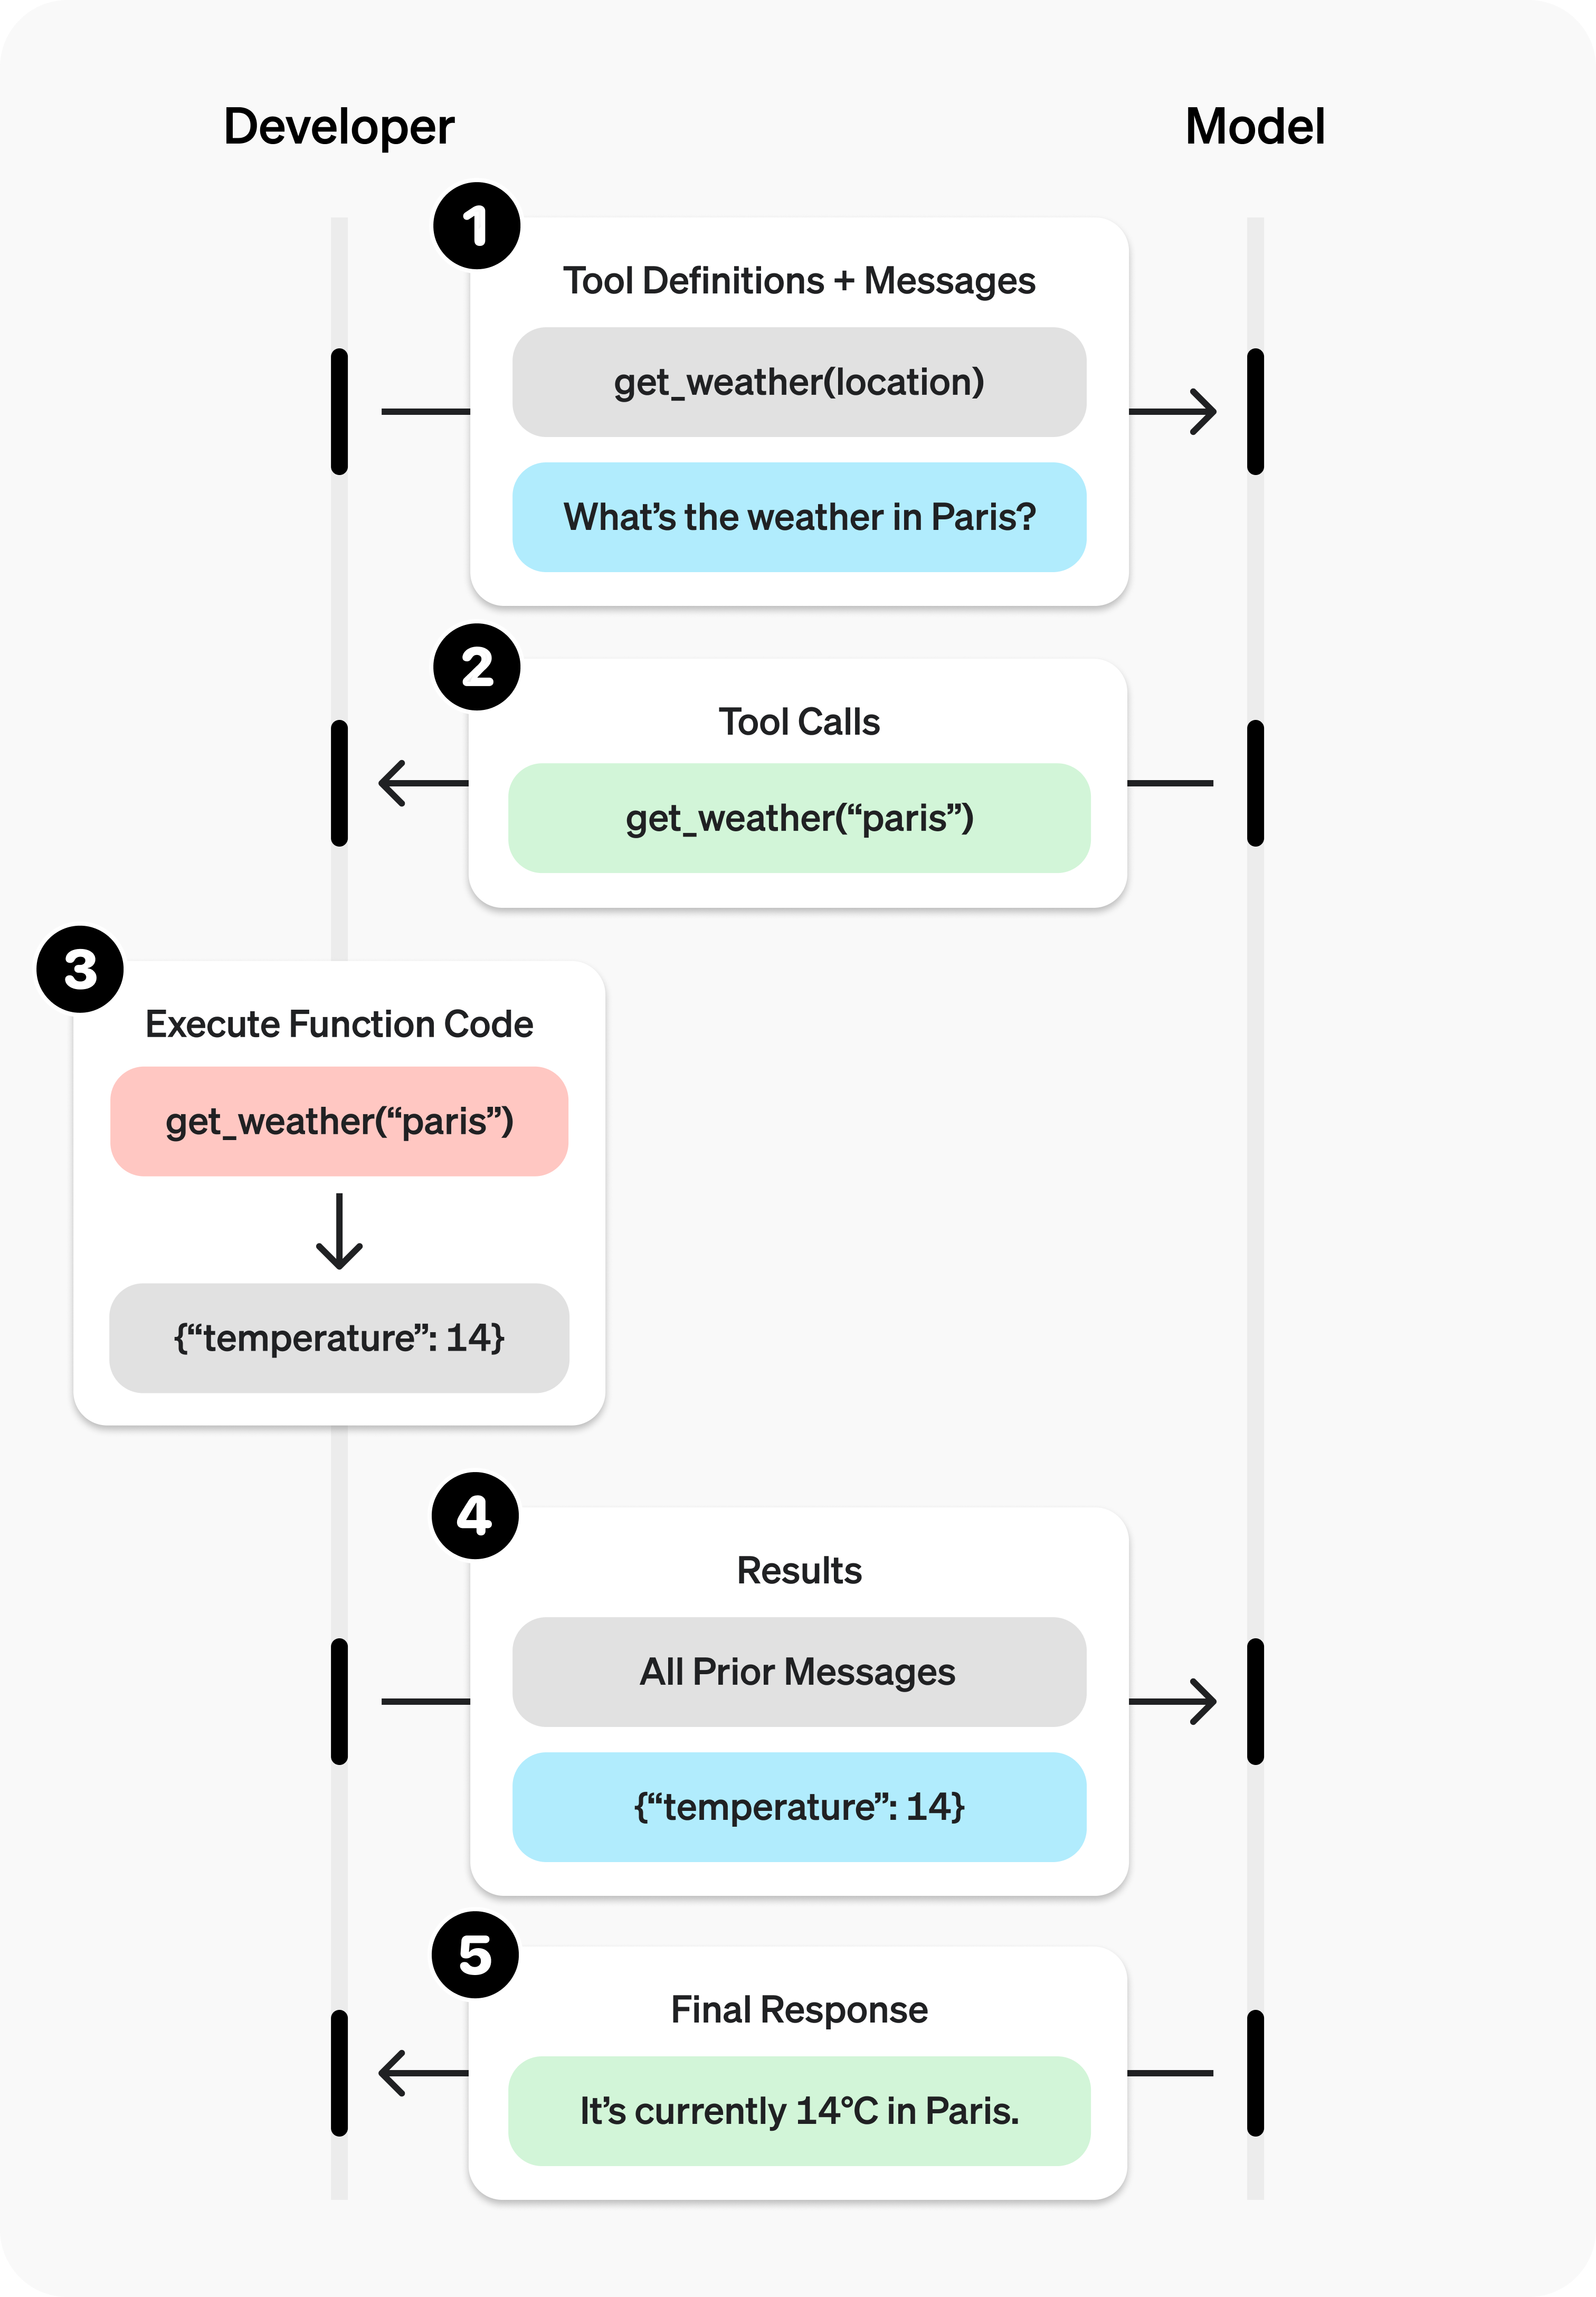
图中的关键分工是:模型提出需要执行的动作,应用实际调用工具,再把结果传给模型。判断输出是否完整,要看工具有没有执行成功、回传了什么结果,以及模型有没有把结果用于后续判断。接入自己的函数时,从一个能够明确验收的动作开始,例如只读查询库存;确认参数、异常和返回格式后,再逐步增加其他操作。
怎样开始:先做一个可以验收的小任务
在 Codex 或 ChatGPT Work 中,先确认账户的模型选择器里有 Astra,再选择已有的项目或资料。初次使用可以交给它一个边界清楚的任务,例如“找出这段导入流程漏掉重复记录的原因,给出最小修复,并用两组输入验证”。检查结果时看修改的位置、测试输入和输出,而不只看它解释得是否流畅。
在 CLI 中可以使用 codex --model gpt-6-astra。这条命令只是选择模型,访问资格仍由账户、登录方式和工作区设置决定。企业与教育工作区的 Astra 在发布时默认关闭,需要管理员开启;本地配置不能绕过工作区限制。
API 开发者应优先从 Responses 接入。下面是一个代码示例,安装 SDK 并在环境中设置 OPENAI_API_KEY 后才会实际发起请求。示例只使用文本,适合先确认响应与费用,再逐步加入工具。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    max_output_tokens=4000,
    input="请为一个 CSV 导入功能设计验收清单,覆盖重复数据、空值和回滚。按可执行步骤输出。"
)
print(response.output_text)
价格、推理强度与速度应分开看
API 价格表以每百万 token 计费。Standard 短上下文价格为输入 10 美元、缓存输入 1 美元、缓存写入 12.50 美元、输出 50 美元。输入超过 272K token 时,整次请求按长上下文价格计费:输入 20 美元、缓存输入 2 美元、缓存写入 25 美元、输出 75 美元。工具费用还需另外计算,不能只看模型输入单价。
推理强度控制思考投入,速度档位控制服务方式,两者不是同一项设置。可以从一个适中的推理档位开始,对难题再增加投入;没有必要把所有简单任务都放在最高档。API 的 none 和 minimal 不适用于 Astra。Codex 与 Work 中的 Ultra 使用子智能体并行处理,不能当成 API 的 reasoning.effort 枚举直接照搬。
API 还提供 Fast 与 Ultrafast 档位。Ultrafast 的短上下文输入与输出价格分别为每百万 token 60 与 300 美元;使用前应读对应接口与限制。订阅产品有独立的额度和资格规则,Work / Codex 速度说明不能直接拿来计算 API 账单。
怎么判断值不值得长期使用
我们的建议是选几项真实任务,记录完成时间、重试次数、人工补改时间和完整费用,再和日常使用的模型比较。若 Astra 能减少复杂任务的反复返工,高单价可能得到回报;若任务只是固定格式转换,较轻的模型通常更容易控制成本。这是选型方法,不是本页已经完成的实测结果。模型输出也应留下来源与验证记录,让下一位接手的人能继续检查。
进一步阅读:GPT-6 使用指南 · Codex 与 Work 模型选择 · 企业工作区模型访问规则。
