一张发布时的成绩单,能让人对下一代 AI 模型有多大信心?2026 年 10 月 1 日,Ishu Agrawal 在 X 上重新贴出 Gemini 3.1 Pro 的官方基准表,并质疑围绕 Gemini 4 Argon 的乐观情绪。Logan Kilpatrick 随后的回复,把话题引向 Google 内部的大规模工程师测试。
这段对话值得讨论,因为它同时暴露了两种容易走偏的判断:把榜单优势直接当成日常体验优势,以及因为过去的体验不佳,就忽略新模型已经出现的新证据。读懂这场争论,需要把历史分数、测试条件和当前进展放回各自的位置。
原帖与回复到底说了什么?
Ishu Agrawal(@ishuagra02 原帖)发表于 2026 年 10 月 1 日 10:32,以下为中文译文,时间为北京时间:
顺便一提,这是 Gemini 3.1 Pro 发布时的官方基准测试,几乎全线碾压了 Opus 4.6。
我并不是说 Gemini 4 Argon 会差,但考虑到 Google 以往的表现,大家居然连一点怀疑都没有,这实在令人难以置信。
同日 12:53,Logan Kilpatrick 直接回复。中文译文如下:
如今,我们在 Google 内部大规模测试模型方面已经有了很大进步。因此,可以认为,大多数新版 Gemini 在发布前,都会经过数千名软件工程师长达数周的测试;希望这已经切实缩小了基准测试与实际使用表现之间的差距。
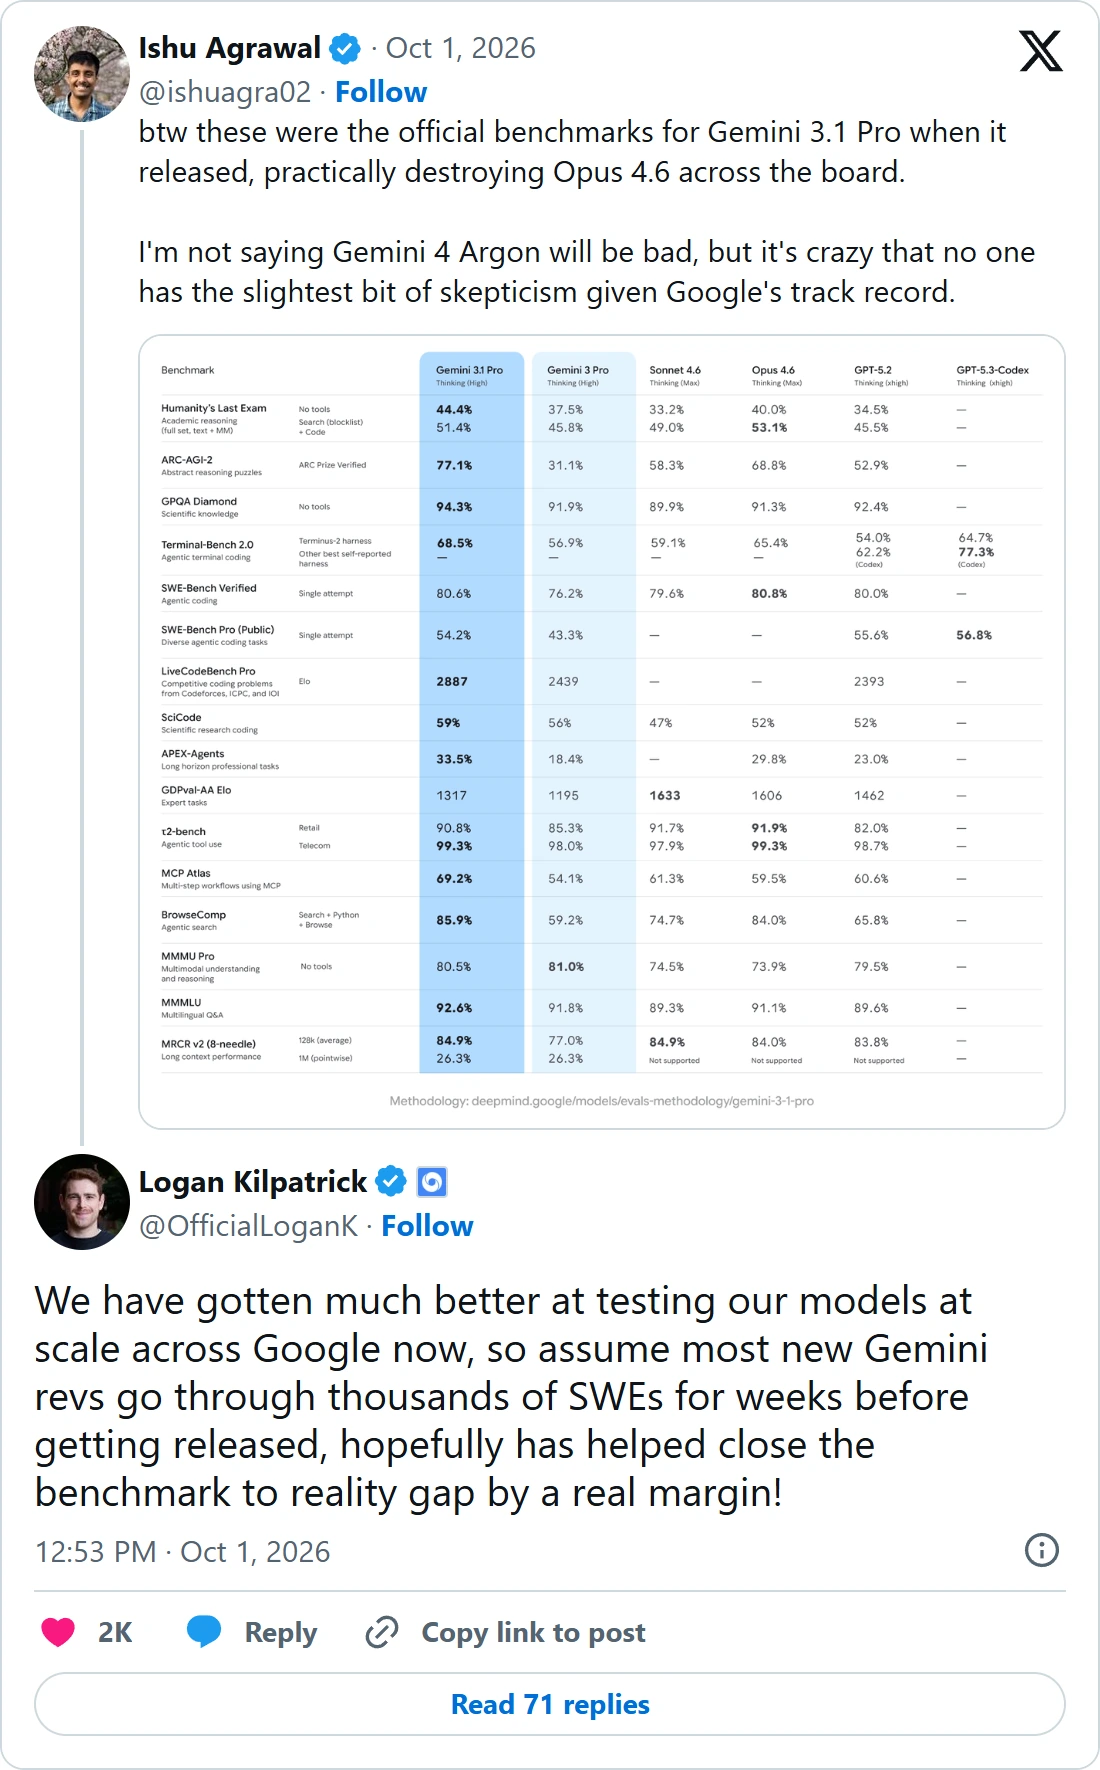
这里的“几乎全线碾压”是 Ishu 的概括,“数千名工程师、数周测试”是 Logan 的说法。前者要接受数据检验,后者说明一种测试过程;两者都不能单独替代最终用户的使用结果。Logan 的原文还用了“hopefully”,表达的是希望差距已缩小,并没有公布差距缩小了多少。
旧榜单确实很强,但并非全面领先
首先要校准时间:Gemini 3.1 Pro 的正式发布公告日期是 2026 年 2 月 19 日。推文引用的是这代模型发布时的表格,并不是 10 月的最新模型排名,更不是 Argon 的测试成绩。
下面选取截图中具有代表性的项目,并与 Google 官方模型卡核对。百分比为对应测试的得分;GDPval-AA 使用 Elo,不是百分比。
| 测试与条件 | Gemini 3.1 Pro Thinking: High |
Opus 4.6 Thinking: Max |
|---|---|---|
| ARC-AGI-2 | 77.1% | 68.8% |
| GPQA Diamond,无工具 | 94.3% | 91.3% |
| Terminal-Bench 2.0,Terminus 2 | 68.5% | 65.4% |
| Humanity’s Last Exam,无工具 | 44.4% | 40.0% |
| Humanity’s Last Exam,搜索(blocklist)与代码 | 51.4% | 53.1% |
| SWE-bench Verified,单次尝试 | 80.6% | 80.8% |
| GDPval-AA,Elo | 1317 | 1606 |
| τ2-bench,零售 | 90.8% | 91.9% |
| τ2-bench,电信 | 99.3% | 99.3% |
这些数字足以说明 Gemini 3.1 Pro 在多项测试中表现出色,也足以否定“各方面都占优”的解读。SWE-bench Verified 的 0.2 个百分点差异,不能据此认定存在显著胜负;但它确实不是 Gemini 的数值领先。GDPval-AA 的 Elo 也不能拿来计算“强了百分之多少”。
更值得留意的是,HLE 的无工具和带工具结果呈现了不同的相对次序。这提醒我们:用户接触到的能力往往取决于整个任务系统。不能仅凭这两行数字,就把差异归因于某一个工具或某一项模型设计。
为什么同一张表,仍不等于同一场考试?
Google 的评测方法说明明确写到,其他厂商的成绩通常采用其自报结果,另有注明的项目除外;SWE-bench 对比使用了不同的代理脚手架和基础设施。因此,同表列出不代表所有模型都在同一套软件与资源预算下重新测过。
代理脚手架可以理解为模型周围的工作环境:它能调用什么工具,如何读取文件,什么时候重试,怎样检查结果。一个模型擅长回答独立问题,并不能自动保证它在包含环境配置、跨文件修改、失败恢复的完整任务中同样领先。
这也解释了为什么“我用起来没有榜单那么好”值得调查,却不能直接推出“榜单是假的”。需要进一步拆开:具体是哪类任务?使用了什么版本和入口?给了多少时间与上下文?失败发生在理解需求、执行工具,还是验收结果?只有把这些条件记录下来,争论才会变成能复现的问题。
数千名工程师内测,能回答哪些问题?
如果模型在真实代码库里被持续使用,大规模内测有机会发现短测题难以覆盖的问题:执行到一半忘记约束,修改了不该动的接口,测试失败后反复绕圈,或者交付了看似完整却无法维护的结果。这是内测具有价值的原因。
但“很多人测过”仍没有回答几个关键问题:与哪个基线比较?成功如何定义?失败和弃用案例是否计入?工程师花了多少时间纠错?参与人数说明覆盖规模,不能直接换算成生产力提升。内部反馈、外部评估与用户自己的验收,应当提供不同层面的证据。
因此,对 Logan 回复的合理理解是:Google 表示正在改善从评测到实际使用之间的验证过程。它值得跟进,但这条回复本身没有证明这种差距已经被消除。
评价 Argon,也必须把新证据算进去
截至本文核查日 2026 年 10 月 2 日,Argon 已不是传闻。Google 于 9 月 30 日正式宣布 Gemini 4 Argon,先向 Fairwind 计划中的可信网络防御者逐步开放,广泛面向开发者和消费者的可用性仍待推进。
早期第三方证据也已经存在。Artificial Analysis 在 9 月 30 日的直接评测中,报告 Argon 在 high reasoning 设置下取得 AutomationBench-AA 78%、Terminal Bench 4 57%。这比单纯依据一张旧发布表讨论新模型,更接近需要回答的问题。
这些结果仍有清楚的适用范围:它们来自特定任务与配置,并非所有工作流的通用保证。尤其不能把 Terminal Bench 4 的 57% 与旧表 Terminal-Bench 2.0 的 68.5% 直接相减,宣称模型退步;测试版本不同。也不要把 AutomationBench-AA 与其他同名近似评测的分数混用。
合理的怀疑,应当允许新证据改变判断。过去的体验可以提高验证要求,却不应预先决定下一代模型的结论。
真正选模型时,应该记录什么?
对于需要用 AI 完成工作的团队,我们建议从自己反复遇到的任务出发,保留相同输入与明确的验收标准,再比较不同模型。以修复程序错误为例,验收不应停在“生成了代码”,而要检查能否运行、是否引入回归、是否满足原有约束,以及别人能否接手维护。
- 可用结果比例:有多少任务通过验收,而不是回答看上去像完成了。
- 人工返工时间:包括检查、修正、补上下文和重新解释需求。
- 完成任务的总成本:把失败重试、工具调用和人工处理一起考虑。
- 稳定性与等待时间:反复运行是否可靠,失败能否及时被发现和恢复。
这场争论最有价值的地方,是提醒我们把注意力从发布表里加粗的数字,移向最终交付的工作。Gemini 3.1 Pro 的优势应该得到承认,旧榜单的边界也应该被看见;Argon 则应由它自己的新数据和实际结果来证明价值。对任何一家厂商,都应采用同样的标准。
编辑说明:本文为资料核验与观点分析,未由 FindGoodAI 独立复跑上述基准。X 原文与回复关系已通过官方嵌入数据核对;译文由 FindGoodAI 整理。历史分数保留发布时口径,核查日期为 2026 年 10 月 2 日。
资料与来源
Google:Gemini 3.1 Pro 发布公告(2026-02-19) ↗
Google DeepMind:Gemini 3.1 Pro 模型卡与历史成绩 ↗
Google DeepMind:Gemini 3.1 Pro 评测方法 ↗
复制链接,保存或分享这篇文章。