同样的 Codex Pro 订阅,为什么有人觉得额度越来越少,也有人觉得更“耐用”?2026 年 10 月 1 日,lifcc(@mylifcc)的一则实测帖子把额度和速度放在了一起讨论。它提醒我们:消耗变慢,也可能只是工作完成得更慢。
原帖与英文译文
原帖是中文,作者称 200 美元套餐的周额度折算约为 933 美元,上次测试约为 1,300 美元;另外列出 GPT-5.6 Sol、GPT-6 Astra、GPT-6.1 Sol 的速度分别为 50、35、20 token/s。以下保留完整原图,并附英文译文图。数字均为作者的个人测试或换算。
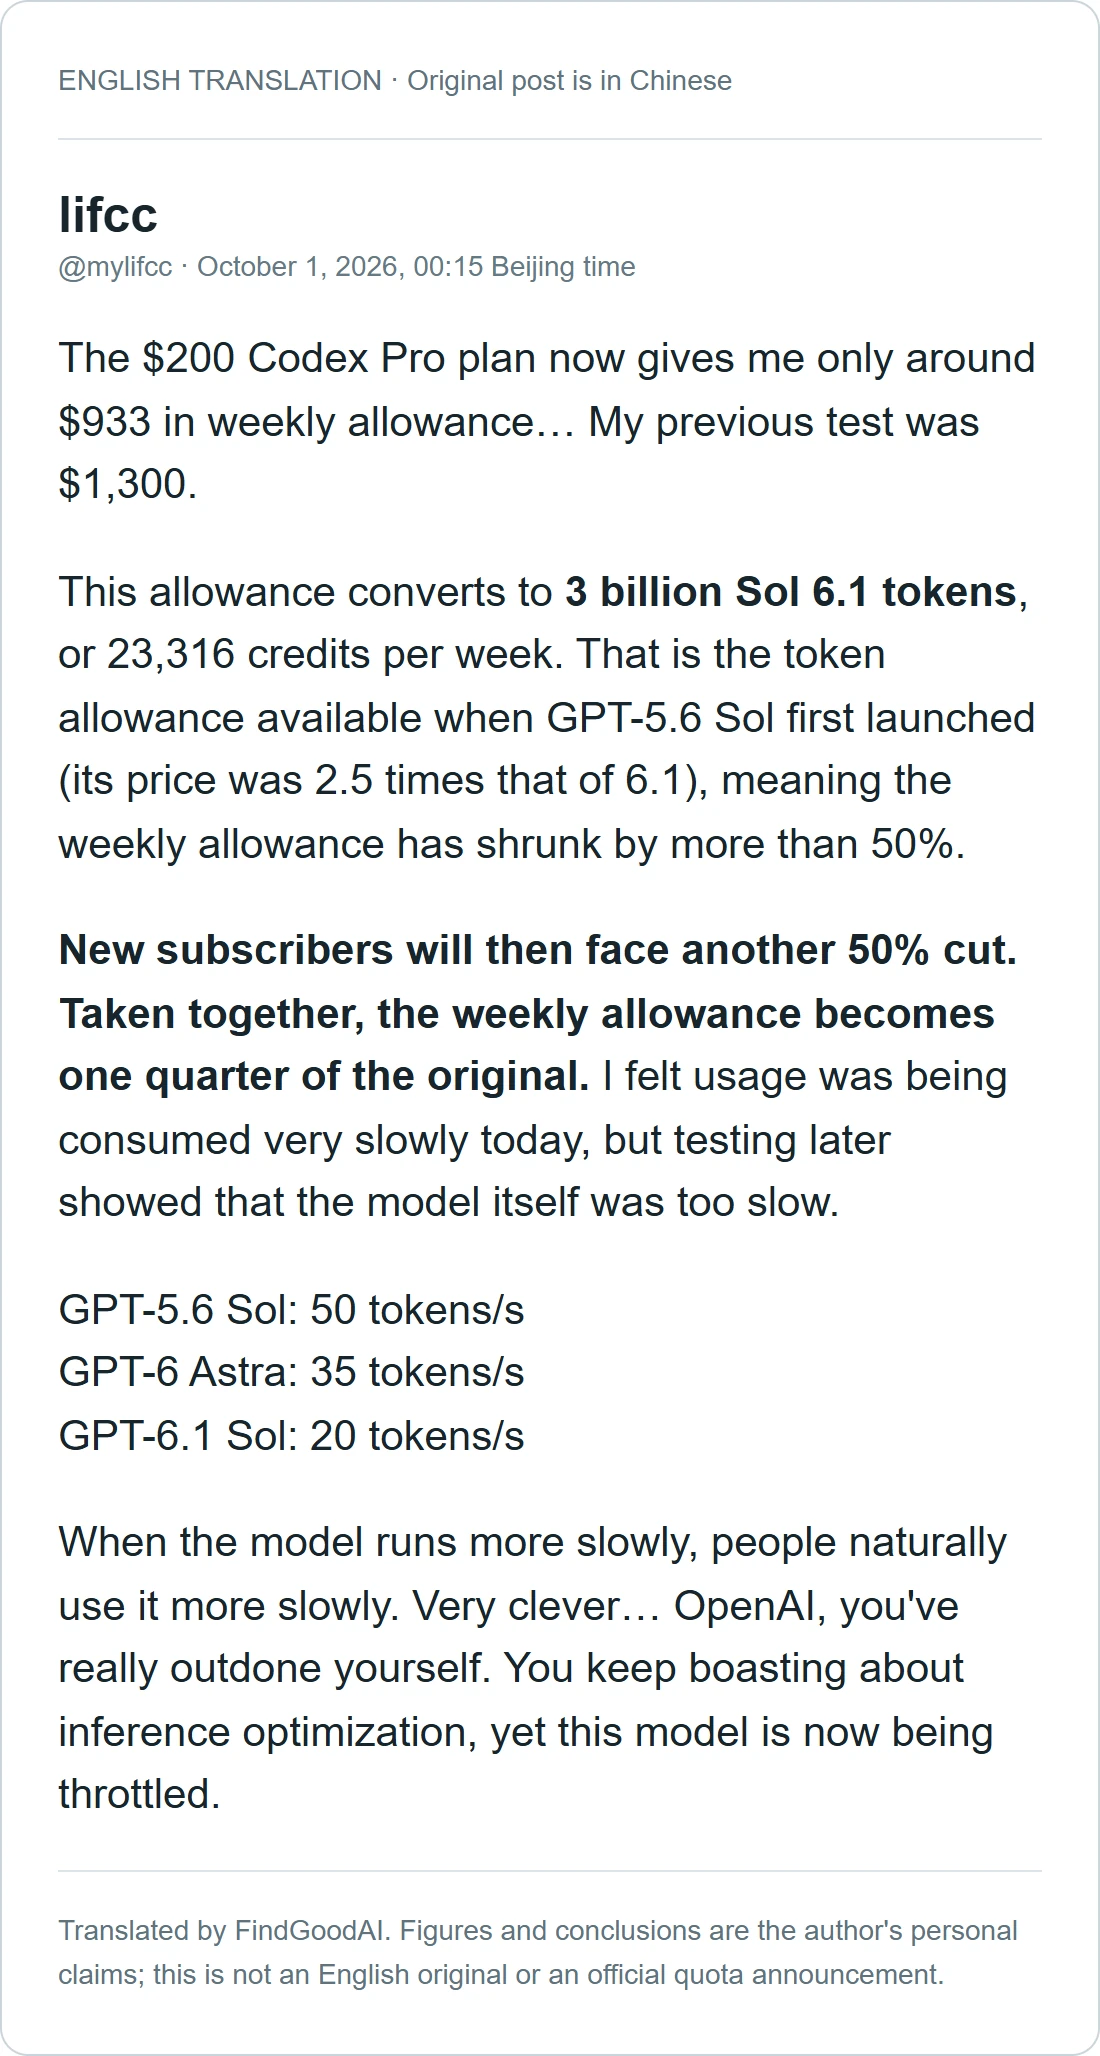
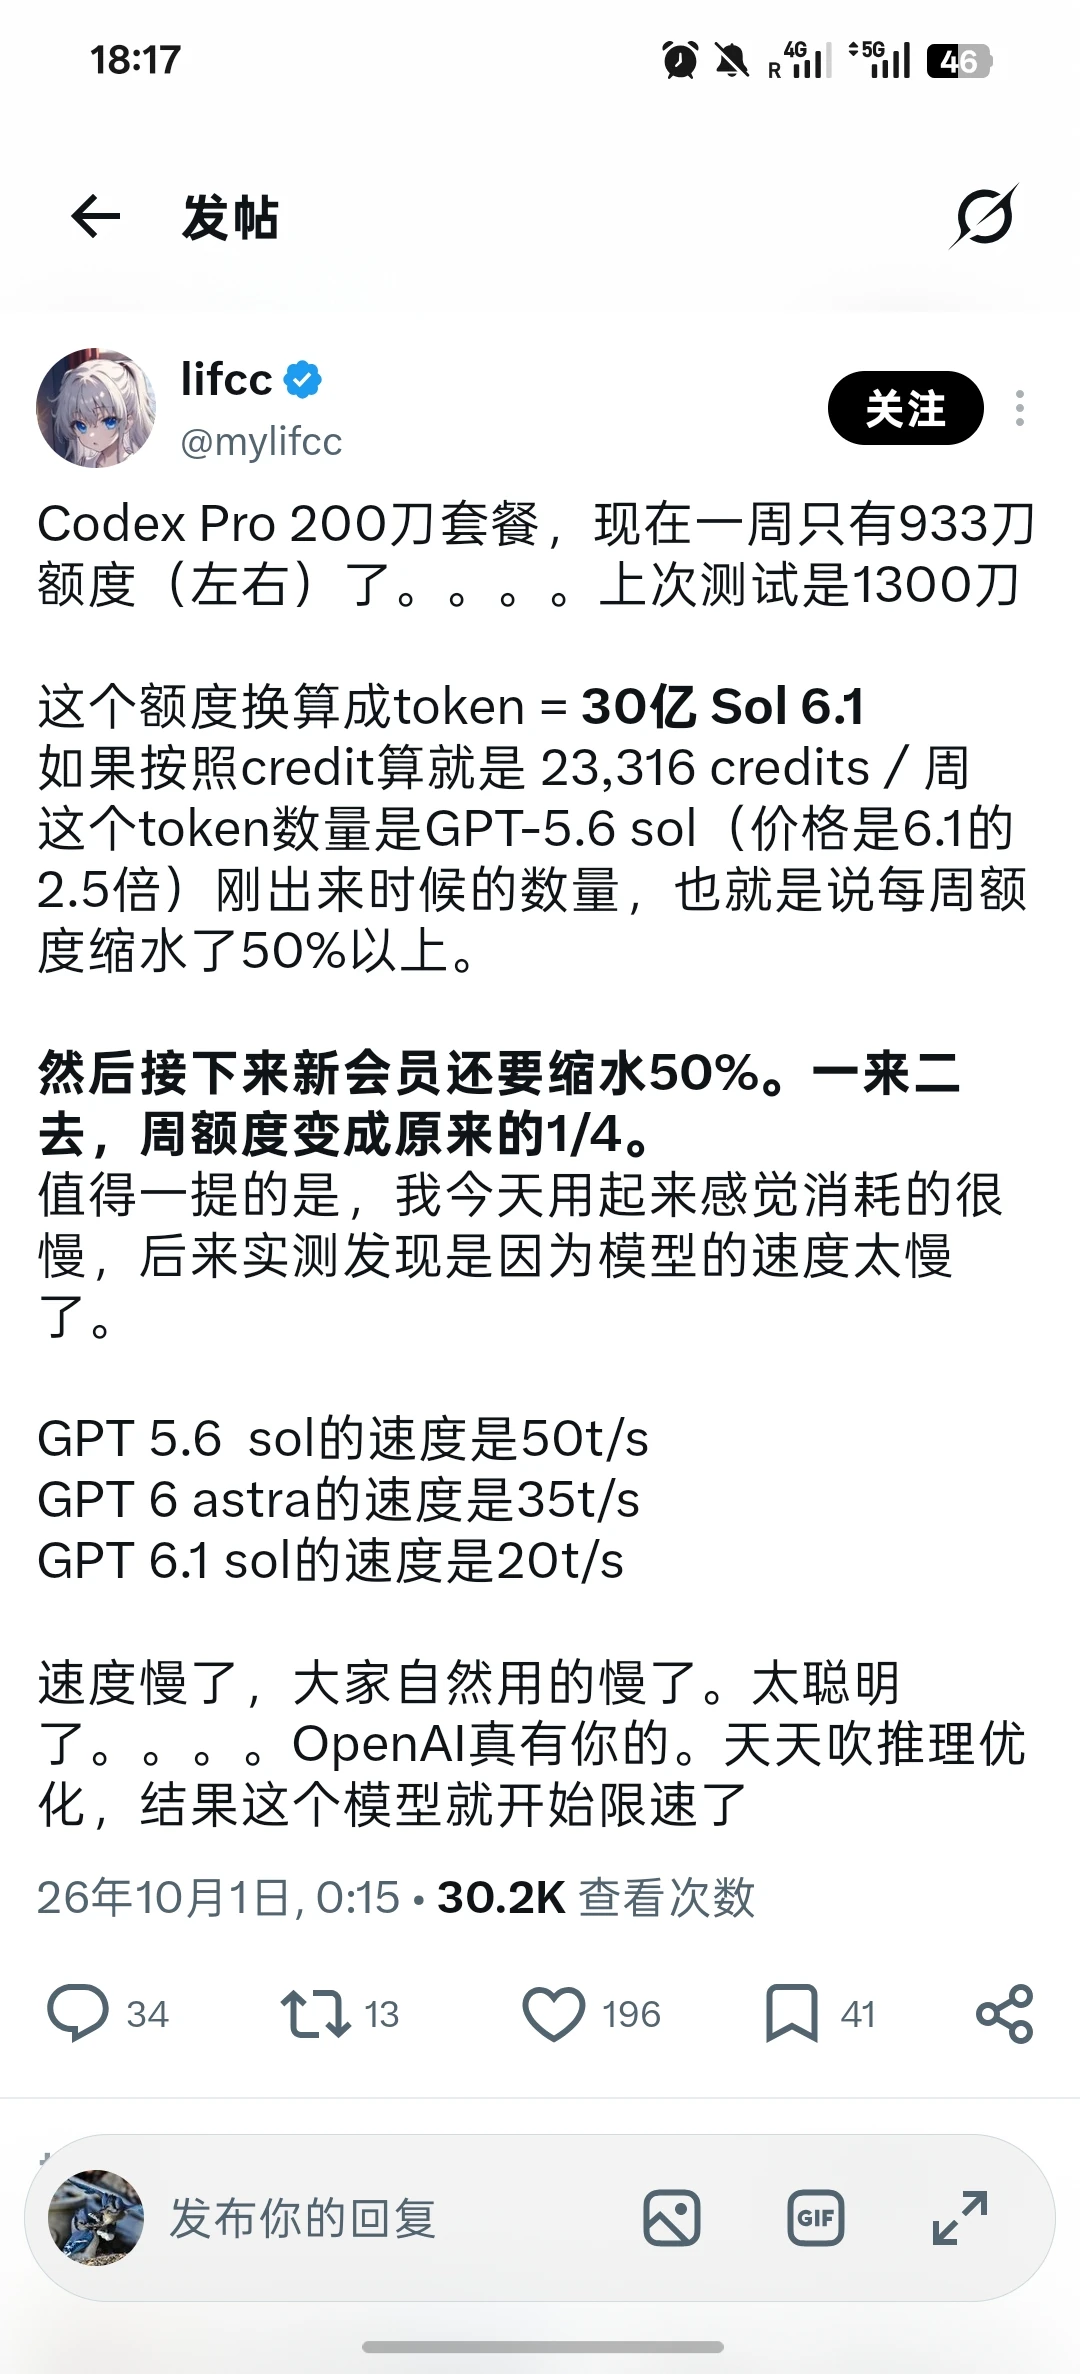
两个数字,不能直接推出“缩水一半”
单看 1,300 与 933,降幅约为 28.2%。原帖的“缩水超过 50%”还涉及旧模型价格、token 数量等比较基准;“变成原来的四分之一”进一步依赖新用户再减半的假设,不能只凭这两个美元数值得出。
933 美元、30 亿 token、23,316 credits 也不是可以不加条件互换的单位。模型、输入与输出比例、缓存及执行方式都会影响换算。OpenAI 官方额度说明明确指出,实际消耗受模型、任务复杂度、上下文和工具使用等因素影响,应查看账户的用量面板。个人测算不等于官方承诺的固定周定额。
消耗慢,要和完成任务的速度一起看
假设输出长度相同,从 50 降到 20 token/s,单纯生成这些 token 所需时间会变为原来的 2.5 倍。单位时间消耗下降,可能让额度显得更耐用,却不表示一周能完成更多工作。不过,单次观察不能证明平台故意限速:首字等待、推理、工具调用、网络及服务负载都会影响总体耗时。
最有用的比较,是拿同一项任务、同一模型设置,记录通过验收的结果、总耗时和额度消耗。额度决定能用多少,速度决定多久做完,质量决定是否需要返工。这三个数一起看,才更接近订阅的实际价值。
本文为简短分析,未独立复跑作者测试。新用户再减半、固定吞吐速度及主动限速的说法,本次核查未找到官方佐证。核查日期:2026 年 10 月 2 日。
资料与来源
复制链接,保存或分享这篇文章。