
Humata
效率办公通过带来源的回答检索、总结和比较上传文档。Humata 提供团队文档访问功能,并以页数额度支持持续知识工作。
跨文件提问引用段落
免费离线 OCR 桌面软件,适合截图取字、批量图片识别和扫描文档整理。它把识别引擎变成易操作的界面,支持结果编辑、排版处理及可搜索 PDF 工作流,不必先搭建 Python 项目。
Umi-OCR 解决的是截图和扫描件里的文字无法直接复制、搜索和继续编辑的问题。相比开发接口,它更适合日常桌面操作:截取一个区域,检查识别结果,再复制到笔记或文档中,整个流程不需要自己写识别程序。
当前项目提供 Windows 与 Linux x64 路线,通过插件使用 RapidOCR、PaddleOCR 等识别引擎。Umi-OCR 本身不是一个全新的识别模型,因此支持语言、准确率和特殊版面能力都与所选引擎有关,不能把界面功能等同于所有模型都能实现。
整理会议截图
建立扫描档案
转录报错信息
制作可搜索资料库
官方图片,可点击放大查看。
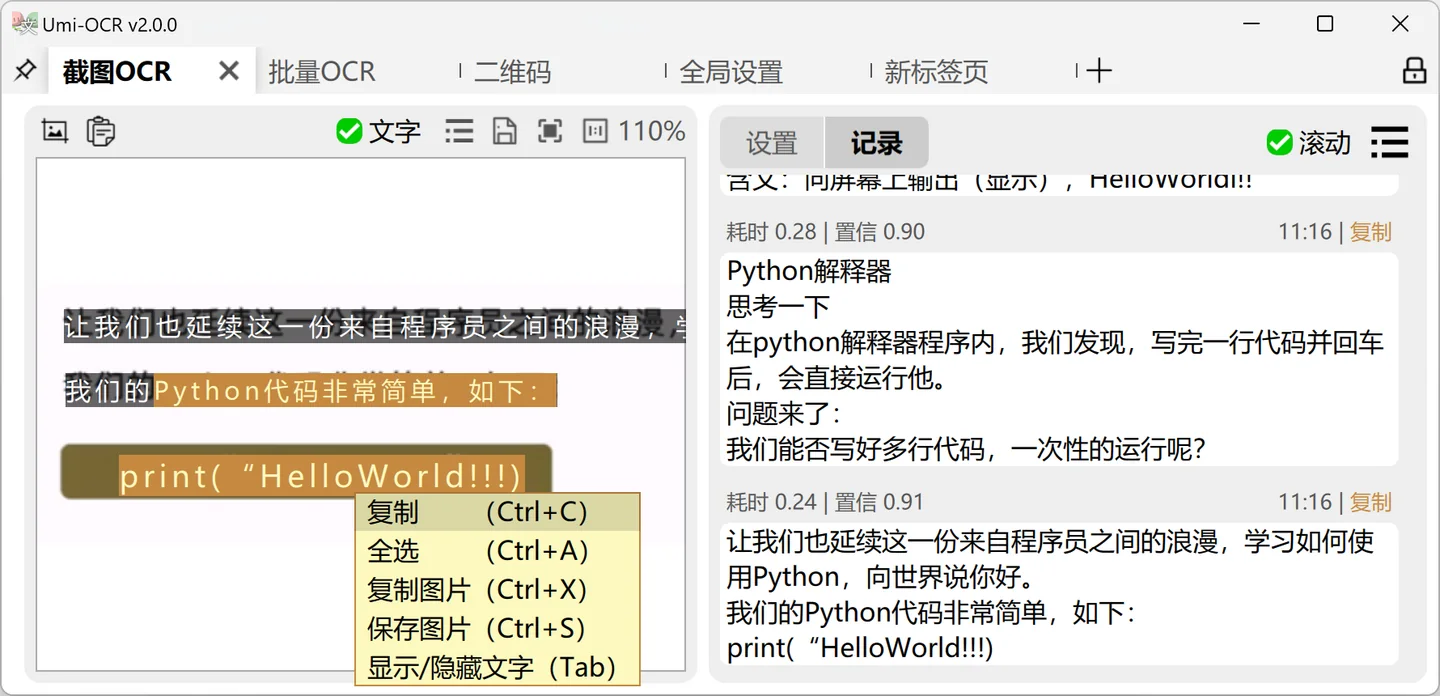
安装对应平台版本
先选代表样页
识别并检查内容
保存可追溯结果
示例提示或操作任务:在本地识别这批会议扫描件,保留页序与技术缩写;导出前逐页核对日期、负责人和行动项编号,不要把模糊字符直接当作确定事实。
以上为编辑建议流程,并非本站性能实测。
Umi-OCR 以 MIT 许可免费开放,本地识别不需要购买按页计费的云 OCR 套餐。但运行仍消耗电脑处理器、内存、磁盘和电力,整批任务速度取决于硬件与图片复杂度。
Umi-OCR 以 MIT 许可免费开放,本地识别不需要购买按页计费的云 OCR 套餐。但运行仍消耗电脑处理器、内存、磁盘和电力,整批任务速度取决于硬件与图片复杂度。
不同识别插件有各自的模型和依赖要求,额外连接的外部服务也应单独查看收费规则。免费软件不代表无限速度、绝对准确或商业级维护承诺,实际选型应结合资料类型与可接受的校对成本。
是,软件以 MIT 许可发布,本地核心识别不按页收取云端费用。
程序、引擎和模型准备完成后,本地识别可以离线进行,下载与更新需要另行安排。
支持,这是它面向桌面用户的主要使用方式之一。
支持批量任务,实际规模受到电脑资源、图片大小和任务耗时影响。
不等于,它主要增加可检索文字,不保证恢复原来的可编辑排版。
当前项目明确提供 Windows x64 与 Linux x64 路线,其他平台应查看后续发布说明。
Umi-OCR 是面向用户的桌面应用,RapidOCR 是可供其使用的识别引擎之一。
平台、输入输出、开源许可和使用条件,完整保留在这里。
Windows 可按官方便携包方式使用,Linux 则应遵循对应安装说明。当前明确列出的桌面目标是 x64 系统,不应仅因界面像网页就推断存在原生 macOS、手机或浏览器版本。
清楚、正向且分辨率足够的图片通常更容易处理。复杂表格、手写字、公式和艺术字体可能需要专门模型或人工校正,应先确认引擎支持情况,不能把普通印刷文字识别能力直接套用到所有文档。
如果实际配置使用本地引擎,离线 OCR 有助于让资料留在自己的机器上。程序、模型和更新应从官方渠道获取;如果主动连接第三方服务,应重新确认数据会发送到哪里。
扫描件转为可搜索文字后,信息更容易被批量查找和复制。共享导出文件前检查是否包含不应公开的信息,并为文字结果使用与原始资料相同的访问控制和保存期限。
正在加载使用体验…
收藏仅自己可见。评论通过审核后公开,修改后会重新审核;评论数量包含获准公开的评论和回复。每人一份评分,新评分自动批准,撤回、未获批准或失效的评分不计入总分。请分享真实体验,避免垃圾信息、私人信息或人身攻击。
审核申诉或数据处理问题: support@findgoodai.com
带上一个真实任务,看看它是否适合你的工作方式。
使用体验