
Google 于 2026 年 9 月 30 日公布 Gemini 4 Argon。它面向需要长时间、多步骤处理的工作:复杂软件工程、企业知识任务,以及网络安全防御。它与常见的“新模型发布后所有人立刻能用”不同,首批先通过 Fairwind 计划交给受信任的网络防御团队测试。查看 Google 原始公告。

这次发布的重点
Google 把 Argon 定位为旗舰级长任务模型,并把输出上限从上一代所述的 64K 提高到 100 万 token。上限变大,意味着一次任务可以容纳更多推理步骤或更长的工作结果;它不等于每个问题都应该生成海量文本,也不代表模型能无误地处理任意长度材料。公告列举的方向包括代码库迁移、金融研究、法律文档和漏洞发现。
Google 公布了若干内部或第三方评测成绩,例如 DeepSWE v1.1、AutomationBench 与长视频理解测试。阅读这些数字时要连同测试集、任务定义与模型版本一起看;这是发布方报告的结果,不是对每个真实团队工作流的保证。Google 也强调,大规模代码迁移仍需自动检查、模拟测试和人工审查。
逐张看:评测成绩与实际选型
Gemini 4 Argon 评测总览

先看这张总表,再看后面的单项图。总表把不同任务放在一起,但各行的分数不能直接平均成一个“模型实力分”。真正选型时,应先找到与你的工作接近的一行,再比较同一行的模型。表里也有 Argon 没有排在第一的任务:FrontierSWE v2 为 55.0%,低于 GPT-6 Astra 的 65.5%;Terminal-bench 4.0 为 57.4%,低于 Claude Opus 5.5 的 66.4%。这说明任务类型仍然会改变选择,不能只看几张领先的柱状图。
Google 的评测方法说明区分了自行测算、公开榜单与厂商报告等结果来源。这张表不能被当成所有模型都在同一套环境里重新跑过的一次统一对测。比较分数时,还要核对推理配置、工具环境与尝试次数。
DeepSWE v1.1:长任务软件工程
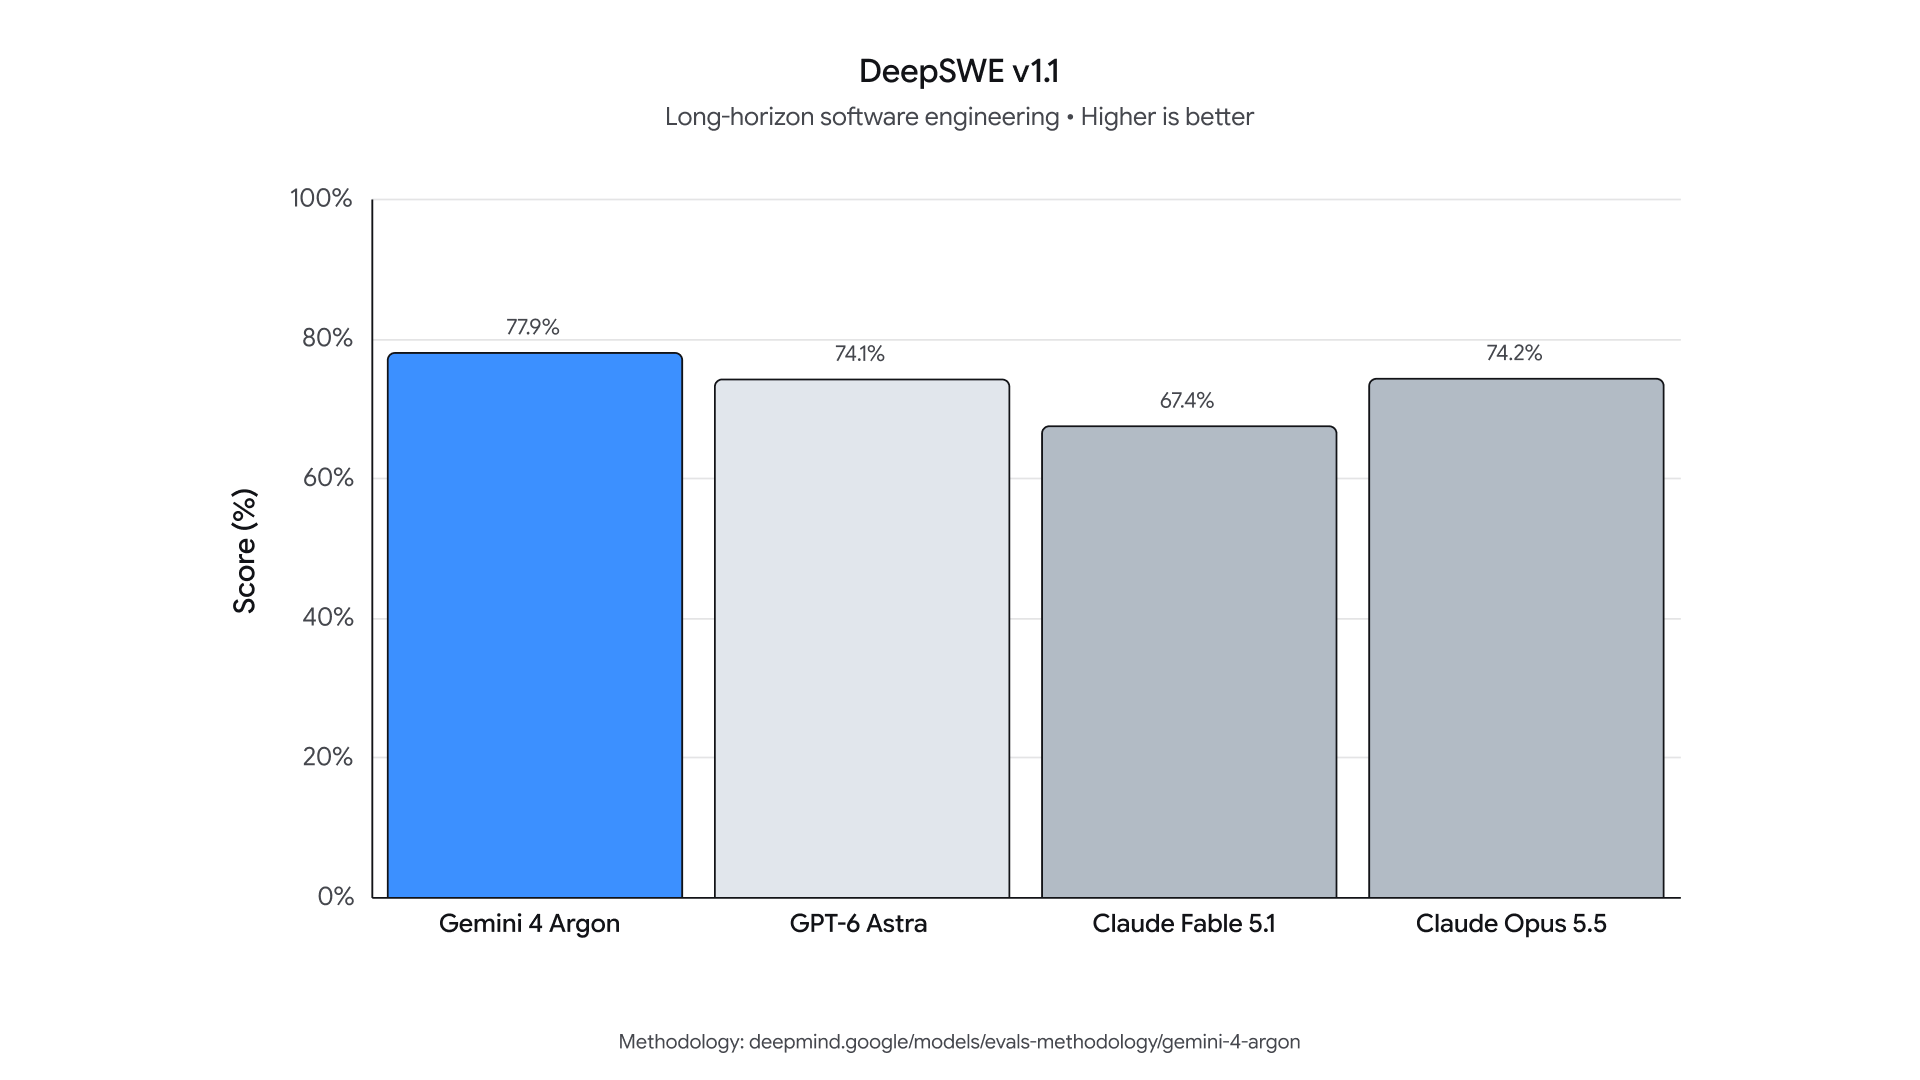
这张图的重点是软件工程中的长任务。对开发团队,值得检验的是模型能否读懂仓库约束、修改相关文件、运行测试并交付可检查的补丁。试用时可以准备三个真实问题:一个有明确失败测试的 bug、一次小范围重构,以及一次依赖升级。分别记录测试是否通过、是否引入无关改动、人工返工用了多久;不要只以代码行数或回答长度作为验收标准。
Vals Index:综合知识工作

综合指标适合帮助你缩小候选范围,但你的团队未必与综合指标采用相同的任务比例。例如,日常主要整理财务资料的人,和主要维护代码仓库的人,需要关注的能力不同。更实用的做法是把一周里反复出现的任务列出来,按实际耗时排序,再选前几项做同题比较。这样得到的是对你有意义的顺序,而不是照搬一张总榜。
Vals Finance Agent v2:金融研究
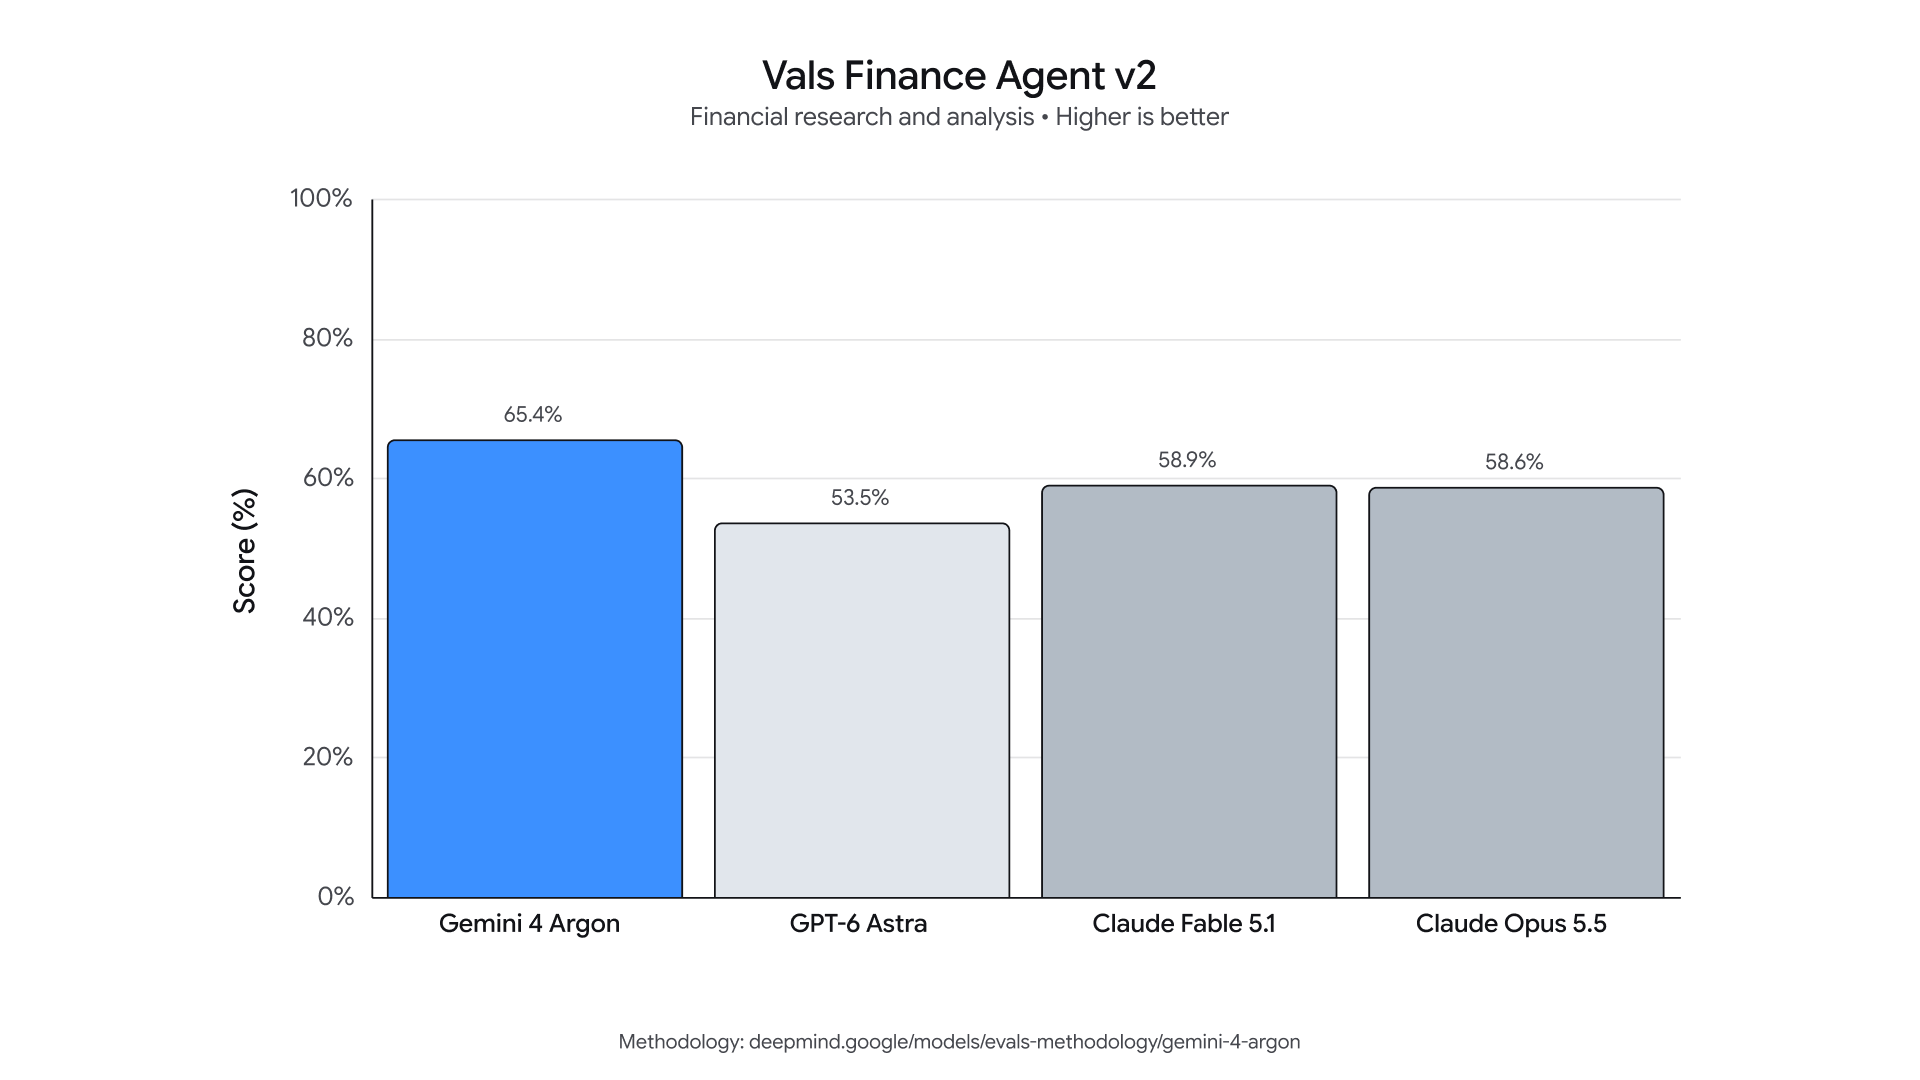
金融研究里,流畅的文字往往容易让错误数字显得可信。可以用同一组报告测试:要求输出一个对比表,并让每个数字指回具体文档、页码或表格位置。随后检查单位、币种、财年和统计口径是否一致。若模型补出了材料里没有的增长率,或者把季度数字与全年数字混在一起,即使报告写得很完整,也应记为失败。
Harvey:法律研究与文书任务

这张图特别值得保留:Argon 的 19.6% 是图中最高分,但最高分与接近满分显然是两回事。实际测试可以要求模型给出带出处的研究提纲,逐条核验引用是否存在、是否适用于问题设定、原文是否支持结论。对于文书草稿,再检查当事人、日期、管辖地等关键信息有没有被改写或遗漏。比较模型时,应把这些错误单独计数,而不是只评语言是否像专业文书。
AutomationBench:业务流程自动化
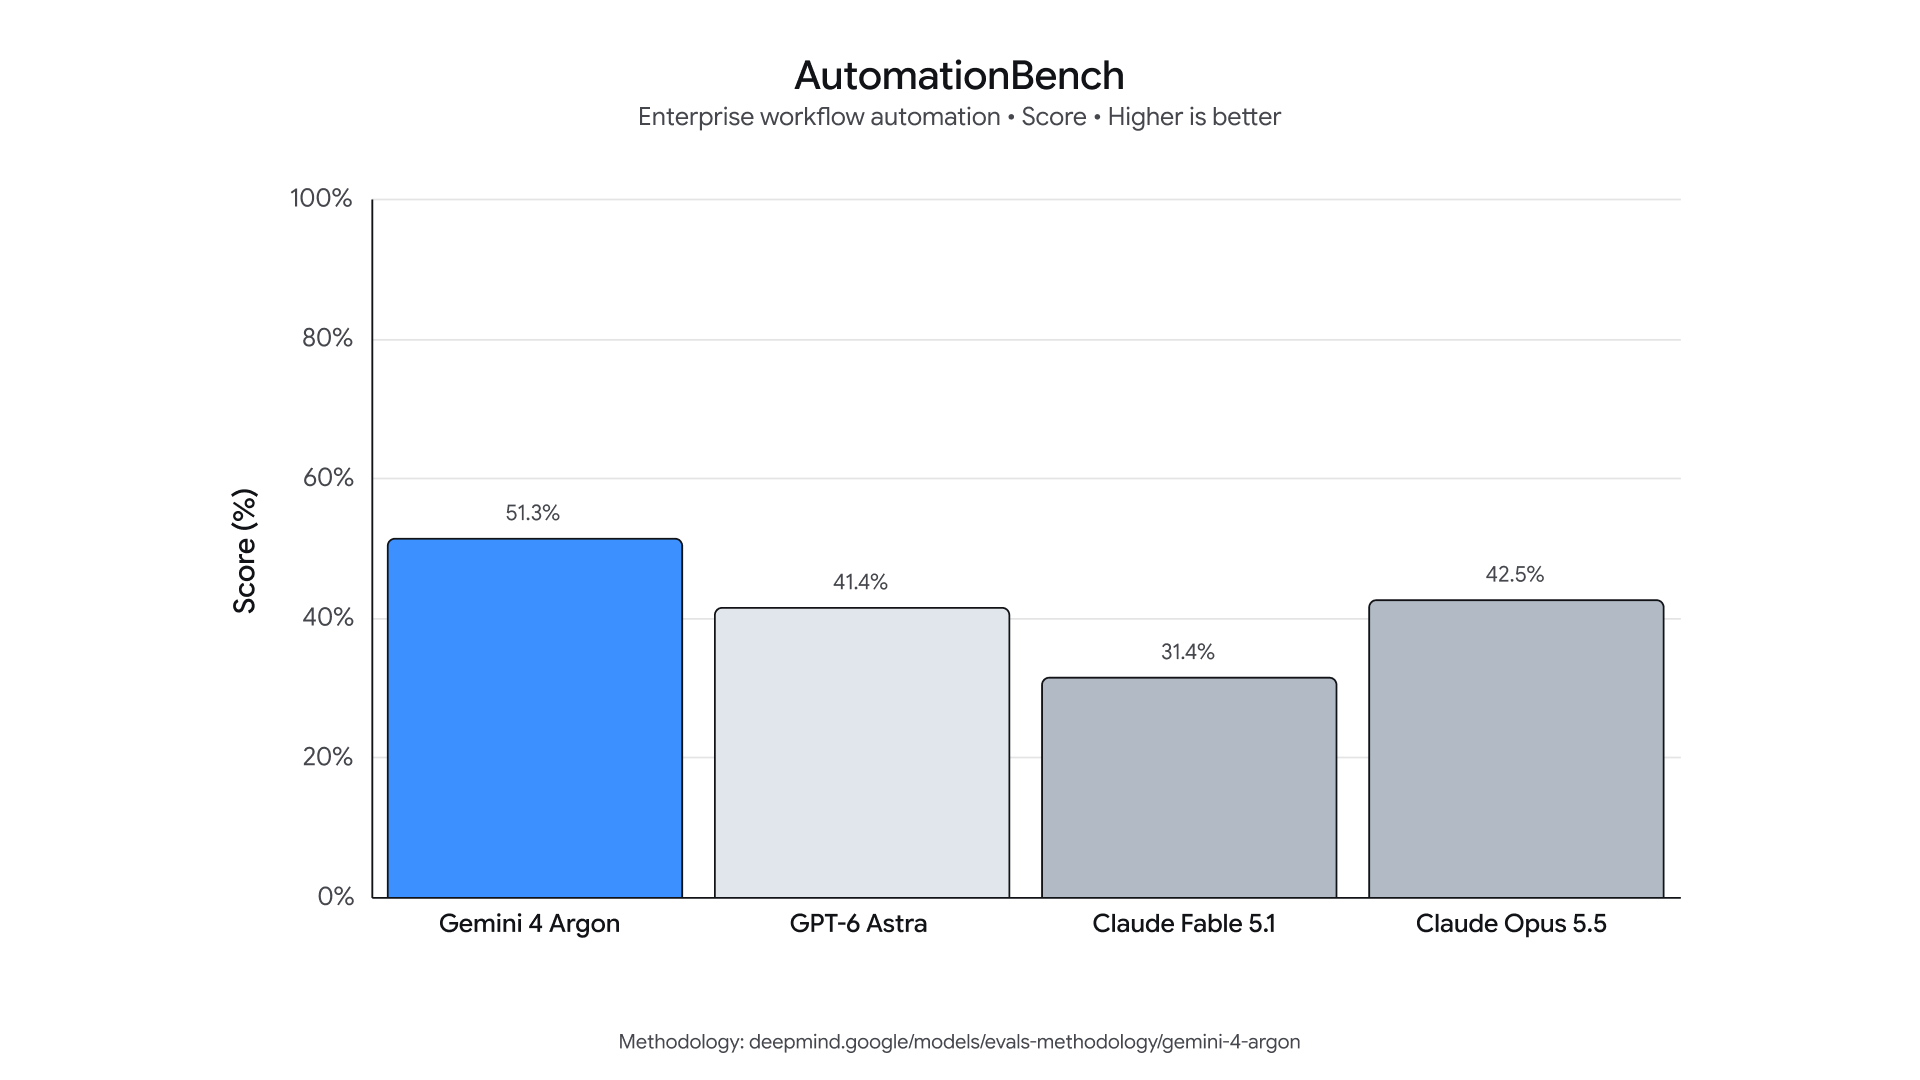
AutomationBench 图中展示的是一套评测的分数,不能读成“企业有 51.3% 的业务已经可以自动无人值守”。落地时,可以先选择一个有明确结束状态的小流程,例如把表单整理成待审核清单。检查是否漏项、写入了错误位置、重复处理记录,以及失败后能否继续运行。最后分别计算模型耗时和人工核对耗时;只有总耗时下降,自动化才对当前流程有实际帮助。
安全评测:修复、发现与提示注入
CWE-bench v1:漏洞修复
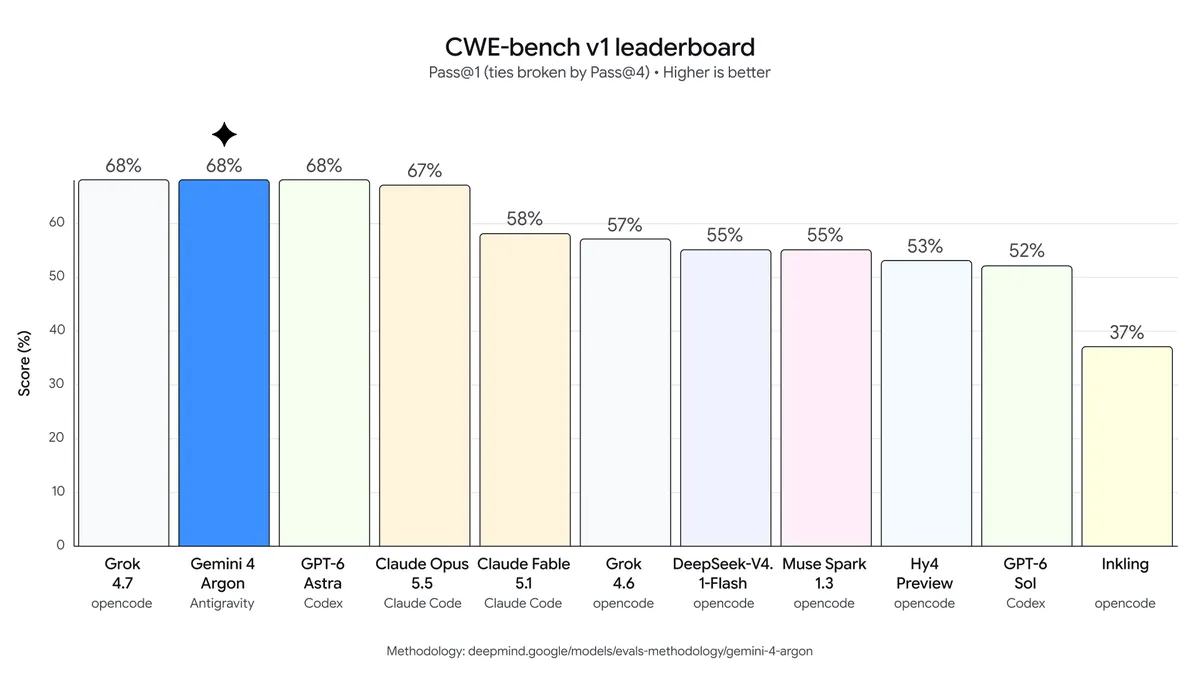
修复漏洞与发现漏洞需要分开验收。针对修复任务,可以先固定一个最小复现和一组回归测试,再检查补丁是否既阻断复现,也保留原有正常功能。特别要留意“删除功能以让测试通过”这类捷径。把补丁限制在独立分支中审查,会比直接接受一个大范围改写更容易判断修复是否成立。
漏洞发现:源码分析与黑盒测试
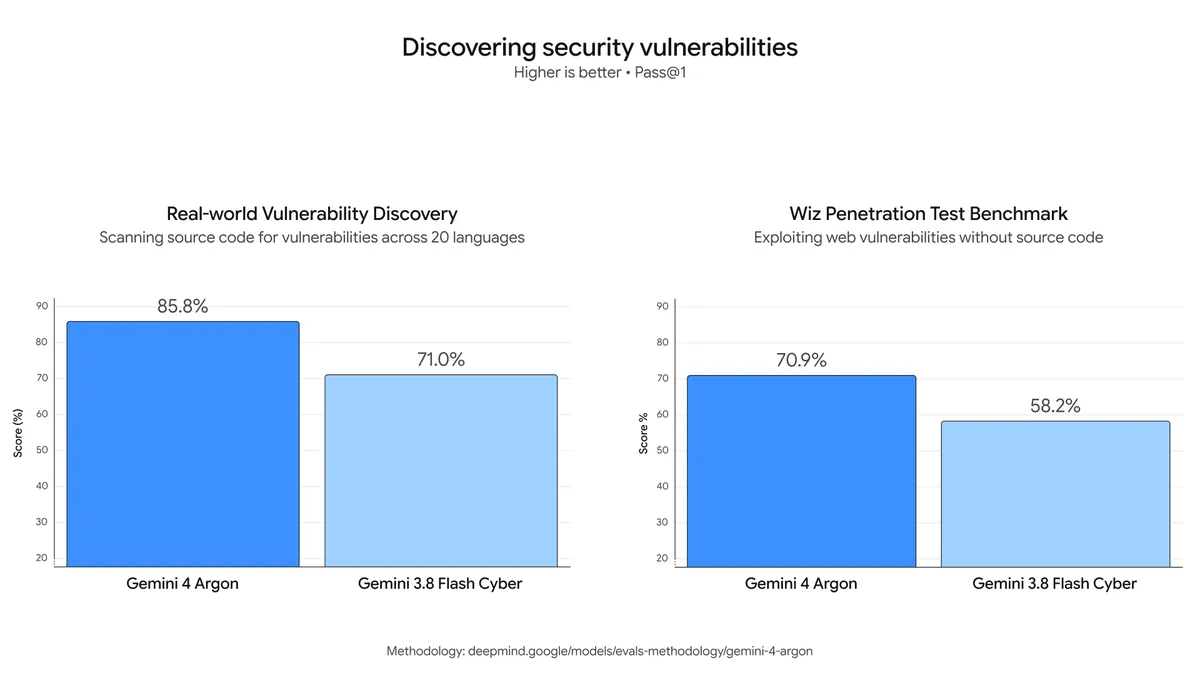
这张图并列展示两种不同测试:能看到源码的漏洞发现,以及看不到源码的黑盒测试;图中还标注了 Pass@1。阅读时要先确认这几个条件,再看柱子的差距。团队复测应固定输入材料、工具权限与尝试次数,并把可复现的问题和没有证据的告警分开记录。一次有效发现不等于对整套系统完成了覆盖;还要记录模型没有检查到的路径,便于后续补测。
Gray Swan IPI:间接提示注入
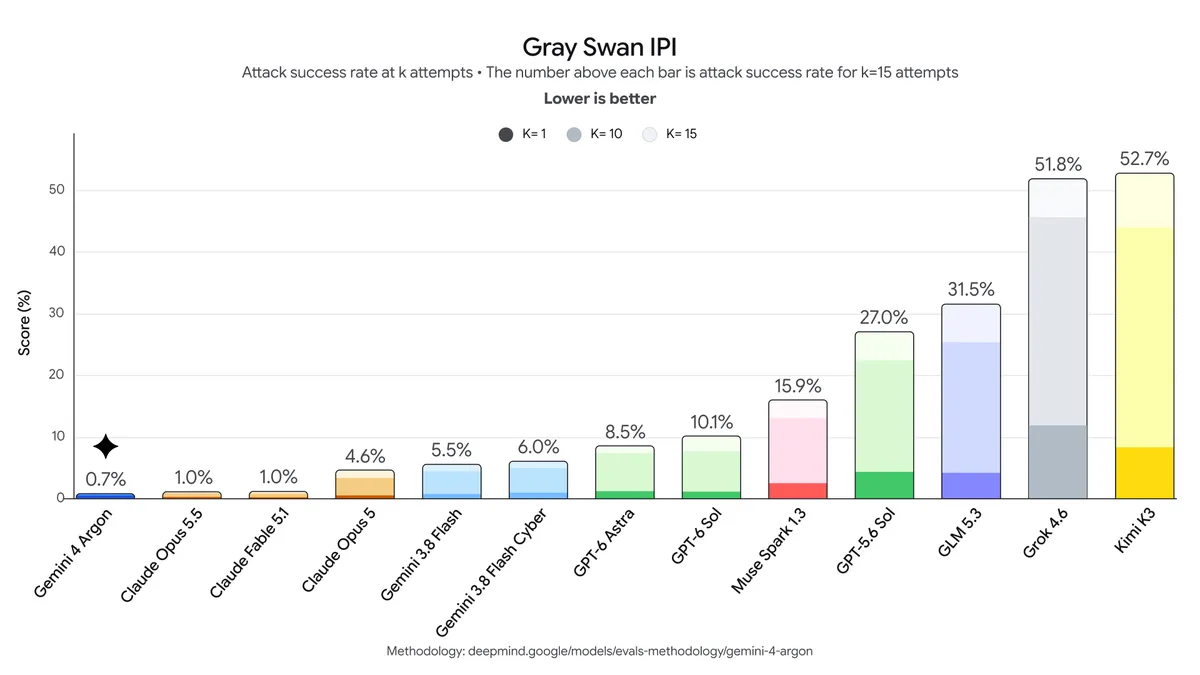
这张图的纵轴是攻击成功率,方向与前面的能力图相反:越低越好。柱子还区分了不同尝试次数,顶部数字对应 k=15,不能混成“一次攻击的成功率”。部署接入网页、邮件或文档的智能体时,可以准备一组带有越权指令的测试材料,观察它是否把材料中的指令当成用户授权。把敏感操作放到单独的授权步骤中,再记录哪些输入会触发错误行动,比只看模型宣称能防注入更有用。
普通开发者现在能不能用
公告发布时,Argon 正先向 Fairwind 计划中的受信任防御人员和早期测试者开放。Google 表示,在加强安全防护并吸收反馈后,才逐步扩大到开发者、企业及消费者;首阶段规划包括付费 API 客户和 Google AI Ultra 订阅者。公告没有承诺所有地区、账户在同一天获得访问,也没有给出面向所有人的完整开放时间表。
适合怎样评估
如果你的团队获准试用,可选择一个范围清楚、结果可复查的长任务,例如在隔离分支中分析一项代码迁移,或让模型对长文档提出带出处的摘要。先设定只读和写入权限,要求它列出修改、证据和待确认事项;再由工程师检查测试结果和安全影响。对安全研究用途,应在授权系统和隔离环境中测试,不能把发布页的“防御能力”理解成自动运行未审批扫描的许可。
发布时的价格与限制
Google 公告给出的引入期 API 价格为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入折扣为标准输入价的 95%;引入期结束后,公告列出的价格将变为输入 4 美元、输出 20 美元。长输出和多轮工具调用会抬高实际账单。部署前还要核实账号是否获准、缓存规则如何计算,以及模型所需的安全防护是否符合本地政策。