
Murf
音频音乐将脚本生成旁白,并通过声音、发音和节奏控制调整表达。Murf Studio 面向内容制作,Murf 的 API、配音与对话智能体产品则处理不同流程。
声音库发音控制
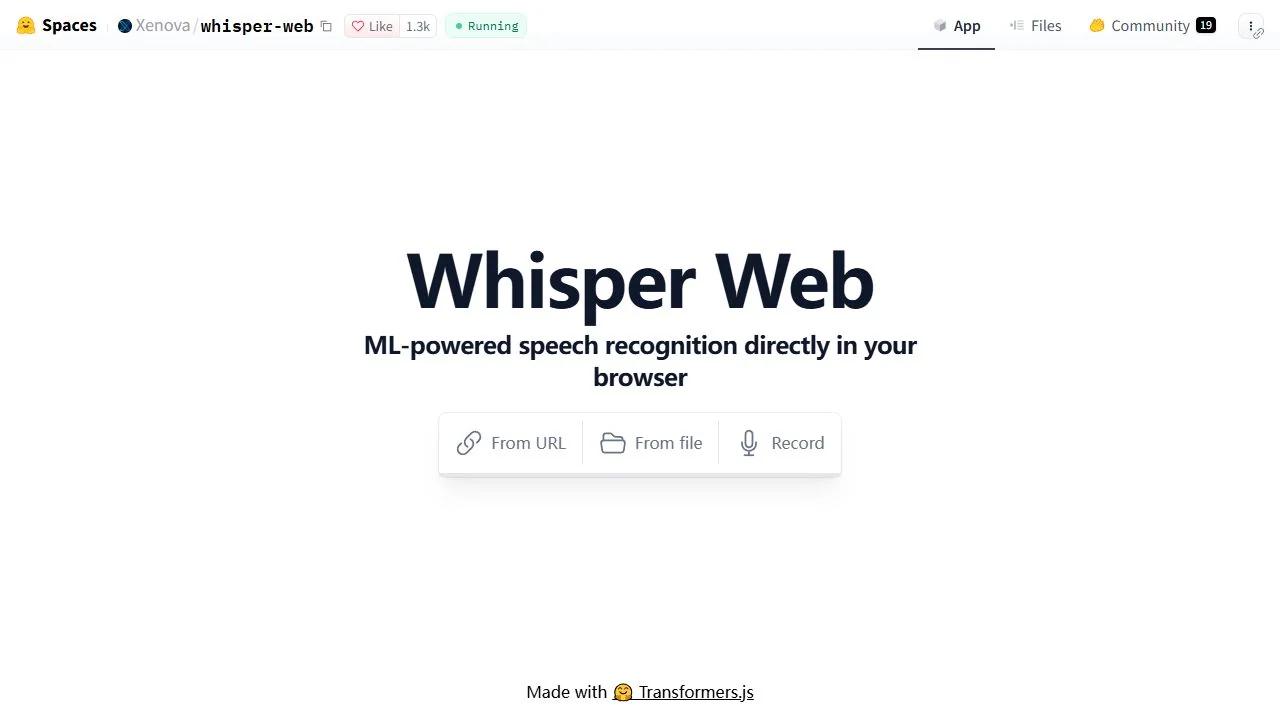
基于 Transformers.js 与 Whisper 模型的免费浏览器语音识别应用,支持文件、音频链接和录音输入,在设备端推理,并提供文本与 JSON 导出。适合短录音整理及浏览器 AI 原型探索。
Whisper Web 展示了通过 Transformers.js 在浏览器中直接运行语音识别的方式。它适合不想先安装完整桌面转写软件、希望尝试设备端处理的用户,也适合研究网页如何集成模型推理的开发者。
应用先下载所需资源,再通过浏览器工作线程处理音频,与把每段录音送给收费云转写服务不同。但它仍需要设备性能、内存和首次网络访问,公共演示也不能被理解为具有可用性承诺的企业转写服务。
整理语音备忘
准备访谈笔记
学习录音解释
开发浏览器 AI 原型
官方图片,可点击放大查看。
准备短录音
加载输入与模型
对照检查转写
按用途导出
示例提示或操作任务:将这段已获授权的短录音按原语言转写,对照音频检查人名、数字和不清楚的句子。导出可读文字,同时保留带时间信息的片段,方便后续修改。
以上为编辑建议流程,并非本站性能实测。
Whisper Web 使用 MIT 许可,浏览器本地识别不要求购买按分钟计费的云转写套餐。运行由用户设备提供算力,应用和模型下载则消耗网络流量及本地存储。
Whisper Web 使用 MIT 许可,浏览器本地识别不要求购买按分钟计费的云转写套餐。运行由用户设备提供算力,应用和模型下载则消耗网络流量及本地存储。
Hugging Face 公共演示便于试用,但不提供合同式可用性保证。开发者可按仓库说明本地启动;项目另有实验性 WebGPU 分支用于加速探索,不应与默认应用的运行要求混为一谈。
源代码采用 MIT,本地浏览器推理不按转写分钟收取云识别费用。
应用通过浏览器工作线程推理,但需要先获取相应模型资源。
首次页面和模型加载需要访问托管资源,完全离线使用应另外准备环境。
界面提供录音入口,取决于浏览器权限和设备支持。
实现提供 TXT 文本和 JSON 片段导出。
基础转写流程不能被当作自动说话人分离功能。
不是,官方把实验性 WebGPU 能力放在独立分支中说明。
平台、输入输出、开源许可和使用条件,完整保留在这里。
音频解码和模型推理受浏览器、设备内存及模型选择影响。较大模型与长录音可能更加耗费资源,应先用小样本判断,再决定是否适合整批资料处理。
源代码中的导出为 TXT 和 JSON,并不是完整生产字幕包。说话人标签、字幕格式、标点规范或正式发表稿件,可能需要其他工具和人工编辑继续处理。
本地推理减少将录音发送到远程识别 API 的需要,但托管网页仍会从网络加载应用和模型。使用远程音频链接也会联系音频源站,应区分识别发生地点与所有网络访问行为。
敏感录音应先核查实际部署并准备认可的本地环境。获取必要录音权限,正式引用之前对照音频校正,不要把模型生成文字未经检查就当成逐字原话。
正在加载使用体验…
收藏仅自己可见。评论通过审核后公开,修改后会重新审核;评论数量包含获准公开的评论和回复。每人一份评分,新评分自动批准,撤回、未获批准或失效的评分不计入总分。请分享真实体验,避免垃圾信息、私人信息或人身攻击。
审核申诉或数据处理问题: support@findgoodai.com
带上一个真实任务,看看它是否适合你的工作方式。
使用体验