
Humata
效率办公通过带来源的回答检索、总结和比较上传文档。Humata 提供团队文档访问功能,并以页数额度支持持续知识工作。
跨文件提问引用段落
面向搜索与生成式 AI 的本地文档处理工具,将不同格式转换为统一结构,支持 PDF 版面理解、OCR 和开发者接口。软件采用 MIT 许可,模型与外部服务的条件另行核对。
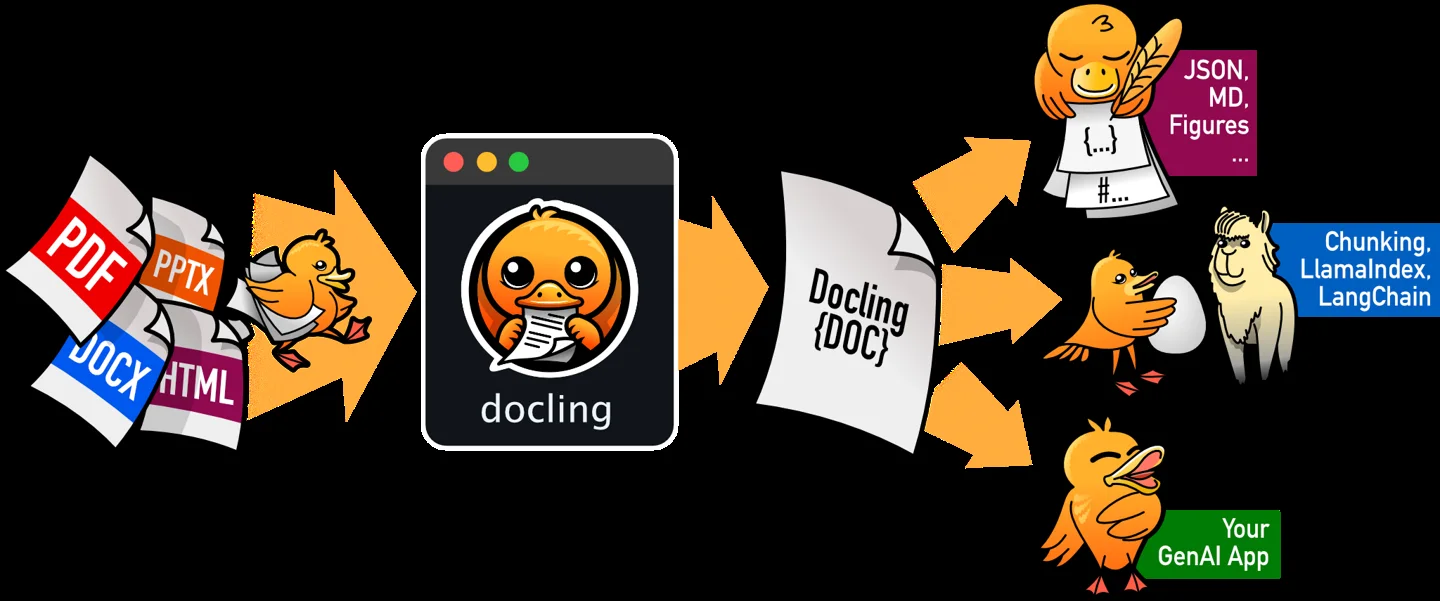
Docling 用于将不同格式文档转换成其他软件能够一致处理的结构。它解决 AI 系统前面的准备环节:理解页面布局、恢复文字和表格,再导出内容,使后续应用不必为每一种文件格式重新实现全部读取逻辑。
混合资料库通常同时包含 PDF、办公文档、网页和扫描件。Docling 不只是把它们转成一大段纯文字,而是提供结构化文档模型,帮助开发者保留元素关系,并检查究竟有什么内容进入了搜索索引或检索增强问答流程。
统一混合资料
准备检索片段
检查扫描档案
提取分析表格
官方图片,可点击放大查看。
选择代表性样本
准备合适环境
转换并比较
逐步接入应用
示例提示或操作任务:将一组公开文档样本转换为结构化内容和 Markdown,保留标题与表格,并记录阅读顺序需要人工复核的页面。
这是建议的验证任务,不代表工具对所有来源具有相同准确率。
软件许可不自动覆盖所有下载模型、远程服务或输入文档的使用权。
Docling 软件采用 MIT 许可,本地运行不要求必须购买服务订阅。计算资源、模型存储与维护由使用者承担,较大规模处理可能需要加速设备或额外基础设施。
可选远程服务、托管集成与下载模型各有条件。MIT 软件许可不能被理解为覆盖所有模型权重和输入文档;封装、分发或商用方案时,应分别核对这些组件的使用要求。
是,项目软件采用 MIT 许可。
不是,主要准备文档内容,问答由后续应用完成。
可以,但离线前需要准备相应模型与资源。
提供 OCR 支持,需要考虑引擎与语言配置。
不是,还提供结构化文档模型与多种导出方式。
不能这样默认,模型与服务许可和工具包许可分开判断。
需要,分析前核对单元格结构、单位和关键数值。
平台、输入输出、开源许可和使用条件,完整保留在这里。
官方安装说明覆盖 macOS、Linux 与 Windows,不同平台的依赖和加速方式可能不同。应选择受支持的环境,不能因为一个示例命令很短,就默认所有可选流程已经安装完成。
准备好本地资源后可以离线处理,否则首次运行可能仍需下载模型。若结果要进入可重复的研究或生产流程,应记录 OCR 引擎、解析管线和模型版本,减少后续难以解释的差异。
本地处理有助于控制文档数据,但仍需检查是否启用了远程模型或可选增强服务。让实际网络行为与资料库的数据规则一致,而不是只依据“本地工具”的名称判断。
中间文件和索引也应得到保护。转换可能让过去不易发现的文字进入搜索系统,因此共享应用消费结果时,仍要落实文档级访问规则,避免不同用户读取彼此无权查看的内容。
正在加载使用体验…
收藏仅自己可见。评论通过审核后公开,修改后会重新审核;评论数量包含获准公开的评论和回复。每人一份评分,新评分自动批准,撤回、未获批准或失效的评分不计入总分。请分享真实体验,避免垃圾信息、私人信息或人身攻击。
审核申诉或数据处理问题: support@findgoodai.com
带上一个真实任务,看看它是否适合你的工作方式。
使用体验