
Jev 是 TypeSafe AI 推出的 System One 决策模型。它接收当前情境和预先定义好的问题,返回程序能够直接读取的选项、分数与概率。想把一封邮件分给正确团队、为检索段落排序、判断一个工单是否需要人工接手,可以从这里开始;想让模型写文章或生成代码,则需要另一个生成式模型。
先弄清它在应用里的位置
把模型放进软件,并不意味着每个步骤都要交给模型。以工具目录为例,读取网址、检查字段是否缺失、按发布日期排序,都可以用普通代码完成。比较棘手的是:一段介绍究竟在讲图片编辑,还是图片生成;一个用户问题需要搜索工具,还是先追问用途。Jev 可以承担这种语义判断,随后由应用执行搜索、显示结果或提出追问。
一个可理解的结构是“读取数据 → 提出有限的问题 → 接收结构化判断 → 用代码执行下一步”。对开发者来说,收益不只在响应快:你可以保存输入、问题定义、模型版本和决定,再检查为什么一条记录走进了某个分支。这个结构也方便替换模型,因为执行逻辑不会散落在一大段聊天提示词里。
三个问题类型怎么选
| Choice:选一项 | 用于互斥分类或工具选择。先定义候选项,再读取选中项及各项概率。例如把用户需求分成 image、video、coding、other。 |
|---|---|
| Score:按量表评分 | 用于可以描述为有序等级的判断,例如“完全无关、部分相关、直接解决需求”。返回分数、各等级概率和置信度。 |
| Noul:判断一个命题 | 用于是或否的问题,返回“是”的概率。例如“这段介绍是否明确提到可商用许可”。它不是相关性程度或质量评分。 |
选项的文字要写清边界。假如“图片生成”和“图片编辑”都包含“处理图片”,分类就容易摇摆。可以把前者写成“由描述创建新图”,后者写成“修改用户已经上传的图片”,再保留 other 接住未覆盖的请求。先做一个容易检查的小判断,比要求一次完成“理解需求、选工具、写回复、调用接口”更容易定位错误。问题格式见 Primitives 文档。
怎样开始使用
先打开 官方 Playground,登录后把一条真实但已去除个人信息的消息放入 state。添加一个 Choice 问题,写出三到五个区别明确的选项,再运行查看结果。不要只用最简单的例子:再试一条同时涉及两种需求的消息,以及一条根本不属于任何选项的消息。这样才能知道它会不会把模糊输入硬塞进某个分类。
确认问题定义有用之后,再接入 API。快速开始 提供 HTTP、Python SDK 与智能体技能三种入口。API 密钥放在服务端环境变量里,页面前端只请求自己的后端。第一次集成可以仅把判断打印出来,不马上触发真实业务动作;等分类结果能与人工标注对得上,再让应用使用它。
当前版本、价格与输入边界
| 核对日期 | 2026 年 10 月 4 日 |
|---|---|
| 版本 | jev-1.13.0;jev-latest 与 jev-preview 当次核对均指向此版本 |
| 调用接口 | POST https://api.typesafe.ai/v1/systemone |
| 输入 | 文本:字符串、JSON 对象或文本数组;不直接接受图片、音频、视频 |
| 上下文 | 整个请求 64k tokens;state 加最长单个问题 32k tokens |
| 官方价格 | 每百万输入 tokens 0.042 美元;输出免费 |
| 官方限额 | 每秒 100k tokens、80 个请求;早期访问期间可能调整 |
这些是 官方模型表 在核对时列出的服务参数。实际项目应记录返回的版本 ID,尤其当你已经为某个版本调过分类阈值时。表里的价格只覆盖模型输入,不包含检索数据库、生成回复、OCR、日志存储或你自己的服务器费用。比如自行假设每次输入 2,000 tokens,10 万次调用共 2 亿输入 tokens,按上述单价约 8.40 美元;实际用量还要把问题和选项文字算进去。
看懂概率,才能把决定用起来
Choice 和 Score 的 confidence 概括了返回概率的集中程度。它可以帮你找出答案摇摆的记录,但不是“这个结果一定正确”的证书。我们更建议在自己的数据上分组检查:高置信度的错误有哪些、低置信度有没有集中在某类输入、改写选项后错误是否减少。置信度文档 解释了其计算方式。
假设你的工具目录按内容类型分类,模型把一条需求判为 coding,但 image 的概率也很高。应用可以先显示两个类别供用户选择,或者询问“你是在做网页代码,还是生成网页配图”。这比默认猜中一种用途后给出一长串不相关工具更实用。对于会改变外部状态的动作,分类结果还应经过原有业务权限与规则;置信度只负责表达模型的不确定性。
官方图表该如何理解
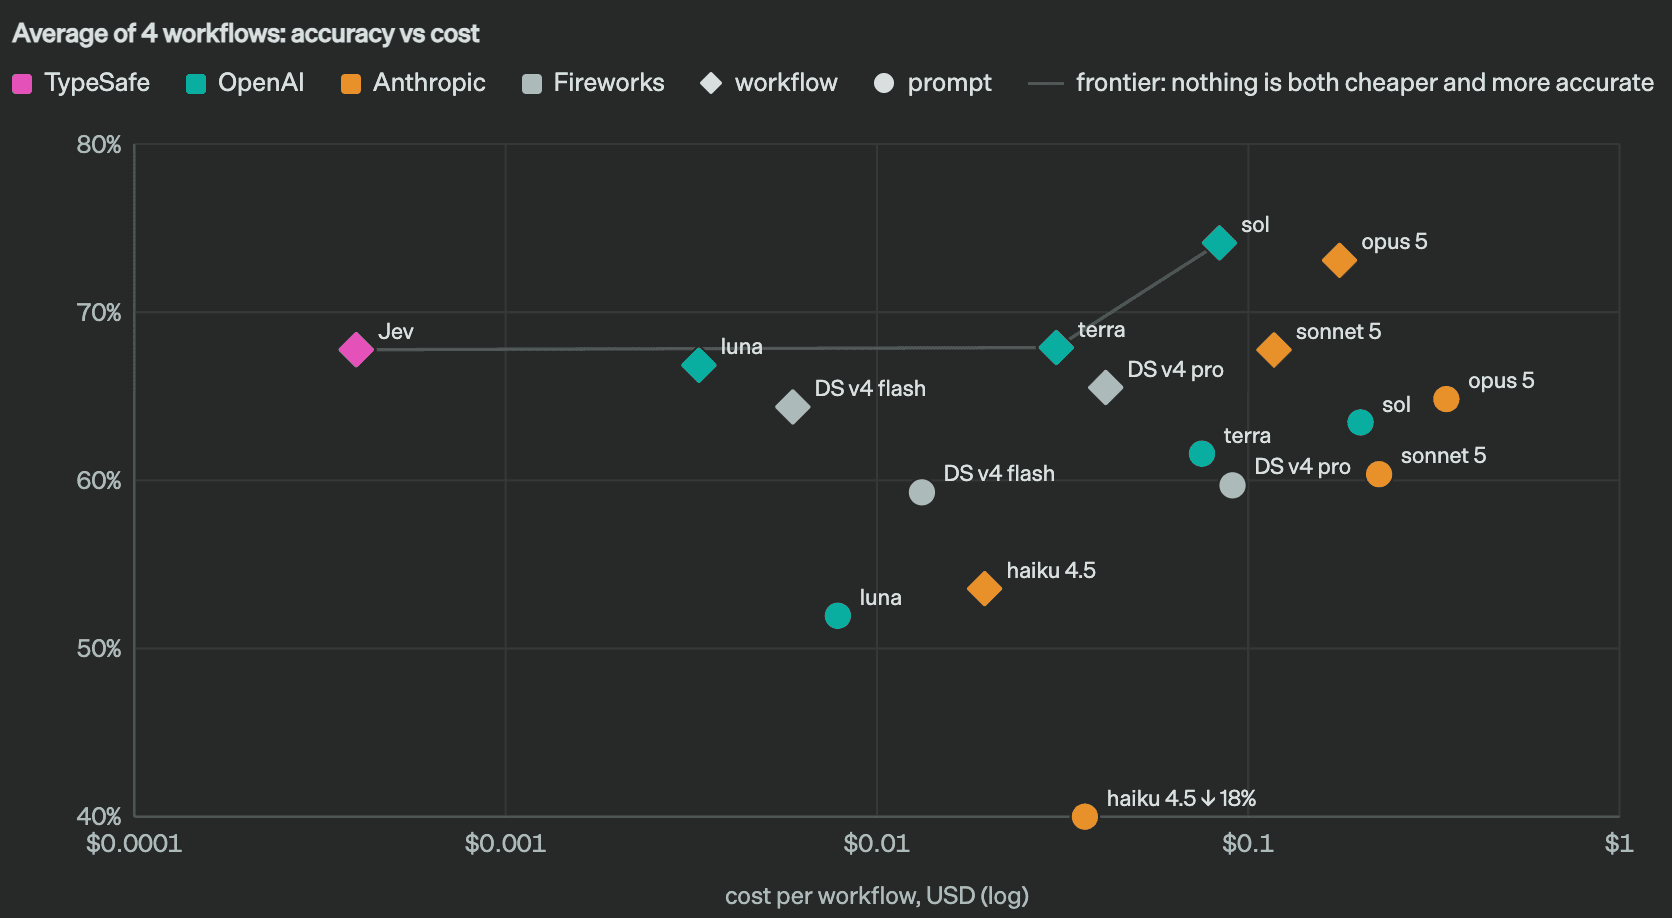
这张散点图把四类工作流的成本与表现放在一起,越靠左代表单次工作流越便宜,越靠上代表该评测的表现越好。菱形和圆形区分了结构化工作流与单段提示方案。比较时要沿着同一种任务和执行方式看,不能只用一个最便宜的点推导所有应用都能达到相同收益。具体案例和比较条件在 Workflow evals 中可逐项检查。
适合的工作,以及不适合的工作
适合优先试的工作是:工具路由、文档分类、工单初筛、候选结果重排,以及为另一个模型提供结构化检查。它们的共同特点是输出范围明确,而且你能收集人工判断作为对照。一个好起点是每次只决定“哪一类”,再逐步增加“是否急迫”“需要哪些资料”等独立问题。
官方 Jev 1.13 已知问题 列出计数、精确数值、日期比较、多层间接推断和对抗性文本等边界。金额汇总、时间差、权限校验交给代码;自由写作交给生成式模型。对于中文输入,可以先准备一批包含行业词、口语和歧义的本地样例,再评估分类是否稳定,不宜直接把英文演示效果当作中文业务的实际效果。
继续阅读与项目入口
Python SDK · JavaScript / TypeScript SDK · 官方智能体技能 · ToolAI Jev 专题。这些入口分别对应接入代码、让编码智能体理解接口,以及延伸项目资料。Jev 本身是模型;SDK 和技能是调用与开发支持,不能当作可下载模型权重。