
GPT-6.1 Sol 是 OpenAI 在 2026 年 9 月 29 日推出的推理模型,面向复杂编程、电脑操作和专业工作。它在当前产品线中承担一个很实际的角色:当任务已经超过简单问答,需要阅读许多材料、修改文件并多次检查结果时,给用户一个能够反复使用、成本低于 Astra 的选择。官方提出的是“接近 Astra 的表现”;具体能否达到你的交付标准,仍应拿同一份任务进行比较。阅读发布介绍。
规格与能力,先分清模型和工具
| 项目 | 已核对的规格 |
|---|---|
| 模型标识 | gpt-6.1-sol |
| 输入与输出 | 文本、图片输入;文本输出 |
| 上下文窗口 | 1,050,000 tokens |
| 最大输入 / 最大输出 | 922,000 / 128,000 tokens |
| 知识截止日期 | 2026 年 4 月 30 日 |
| API 推理档位 | low、medium(默认)、high、xhigh、max |
| 工具调用接口 | Responses API;Chat Completions 不提供工具调用 |
| 标准短上下文价格 | 输入 $2;缓存读取 $0.10;缓存写入 $2.50;输出 $10 / 百万 tokens |
上表来自 GPT-6.1 Sol API 模型页。它能够接收图片,并不等于它的原生输出是图片。设计海报、生成角色或修改图片时,需要工作环境启用图像生成工具;浏览器操作、文件搜索和代码执行也依赖实际开放的工具、权限和客户端。选择模型不会替你接通企业资料,也不会自动把一台电脑或整个文件夹变成它可以操作的环境。
百万级上下文适合把一项工作的相关材料放在同一段上下文中,例如已有接口、数据库结构、几份错误日志和新的功能说明。不过,材料能放下和模型能正确利用是两件事。把当前版本、过期文档、示例数据混在一起,会让判断变得模糊。更好的做法是给资料标注日期和用途,说明哪个文件是事实依据,哪个只是讨论稿,再要求输出时指出所依据的文件或段落。
怎样开始使用
通过 Codex 或 ChatGPT Work 使用时,先检查模型选择器中是否出现 GPT-6.1 Sol。官方首发范围包括 Plus、Pro、Business、Enterprise 和 Edu;Enterprise、Edu 需要管理员启用,Free 和 Go 不在首发范围。模型在 Work 和 Codex 中的可用性不能直接等同于普通 Chat。界面的推理控制可以显示 Light 到 Ultra,具体选项取决于客户端、账户和工作区。它们与 API 参数不应逐字对应:API 明确只支持 low 到 max,不支持 none 和 minimal。查看客户端可用范围。
如果已经安装并登录 Codex CLI,可以使用 codex -m gpt-6.1-sol 启动指定模型的会话。开始第一项工作时,最好选一个成果容易验收的任务:修复一个确定能重现的错误、根据现有品牌页面做一个新页面,或者把一组有来源的会议材料整理成可编辑的报告。给出输入资料、希望拿到的文件和验收条件,效果通常比一句“帮我做一个很好的网站”更容易判断。
三类值得试的实际任务
代码与界面。让它先梳理请求流程,再做最小范围的修改,最后展示页面或测试结果。例如“沿用当前登录和菜单结构,在报表页增加日期筛选;桌面和手机都要可用;给出修改文件与验证结果”。这样既能发挥跨文件工作的能力,也能让你看见它究竟完成了什么。不要只以最后一句“已完成”作为验收,真正有用的是补丁、可运行页面、可重复的测试和剩余问题。
业务材料。把数据表、会议记录、历史方案分别作为输入,要求它先核对口径,再写说明和制作图表。一个合适的要求是“金额按原表计算,缺失值保持空白,观点与事实分别表达,交付一份可编辑的演示文稿”。你可以进一步检查引用、总数和图表轴线,而不是只评价语言流不流畅。这类工作往往需要多次改稿,模型选择时应观察每一轮修改是否仍保留前面确认的事实。
跨应用工作。先给一个窄流程,例如从获准访问的项目文档中整理里程碑,再形成待确认的任务清单。等这个流程稳定后,再扩大范围。关键技能是写清楚触发条件、输入位置和完成状态;让它区分“找到了资料”“做出了草稿”和“已经写入目标系统”。这会比一开始要求它接管所有工作更容易形成可用的习惯。
费用和长任务怎么判断
标准价格中的“每百万 tokens”是计量单位,不是一次任务的费用。输入不超过 272K tokens 时,当前价格是 $2 输入、$10 输出;超过门槛的请求按长上下文价格计算,输入为 $4、输出为 $15,且门槛影响整次请求。Fast 为标准价的两倍,Batch、Flex 则比标准价低 50%;工具和区域处理可能另有费用。查看完整价格表。
我的建议是先把 Sol 作为有预算约束的复杂工作的候选,再拿一个真正困难的任务与 Astra 对照。记录首次通过率、你要补充多少轮指令、总耗时和最终花费。一轮便宜但需要不断返工的结果,未必比一次高质量交付省钱;反过来,如果 Sol 已经稳定达到验收标准,就没有必要因为模型名字更强而为每一项日常工作提高配置。
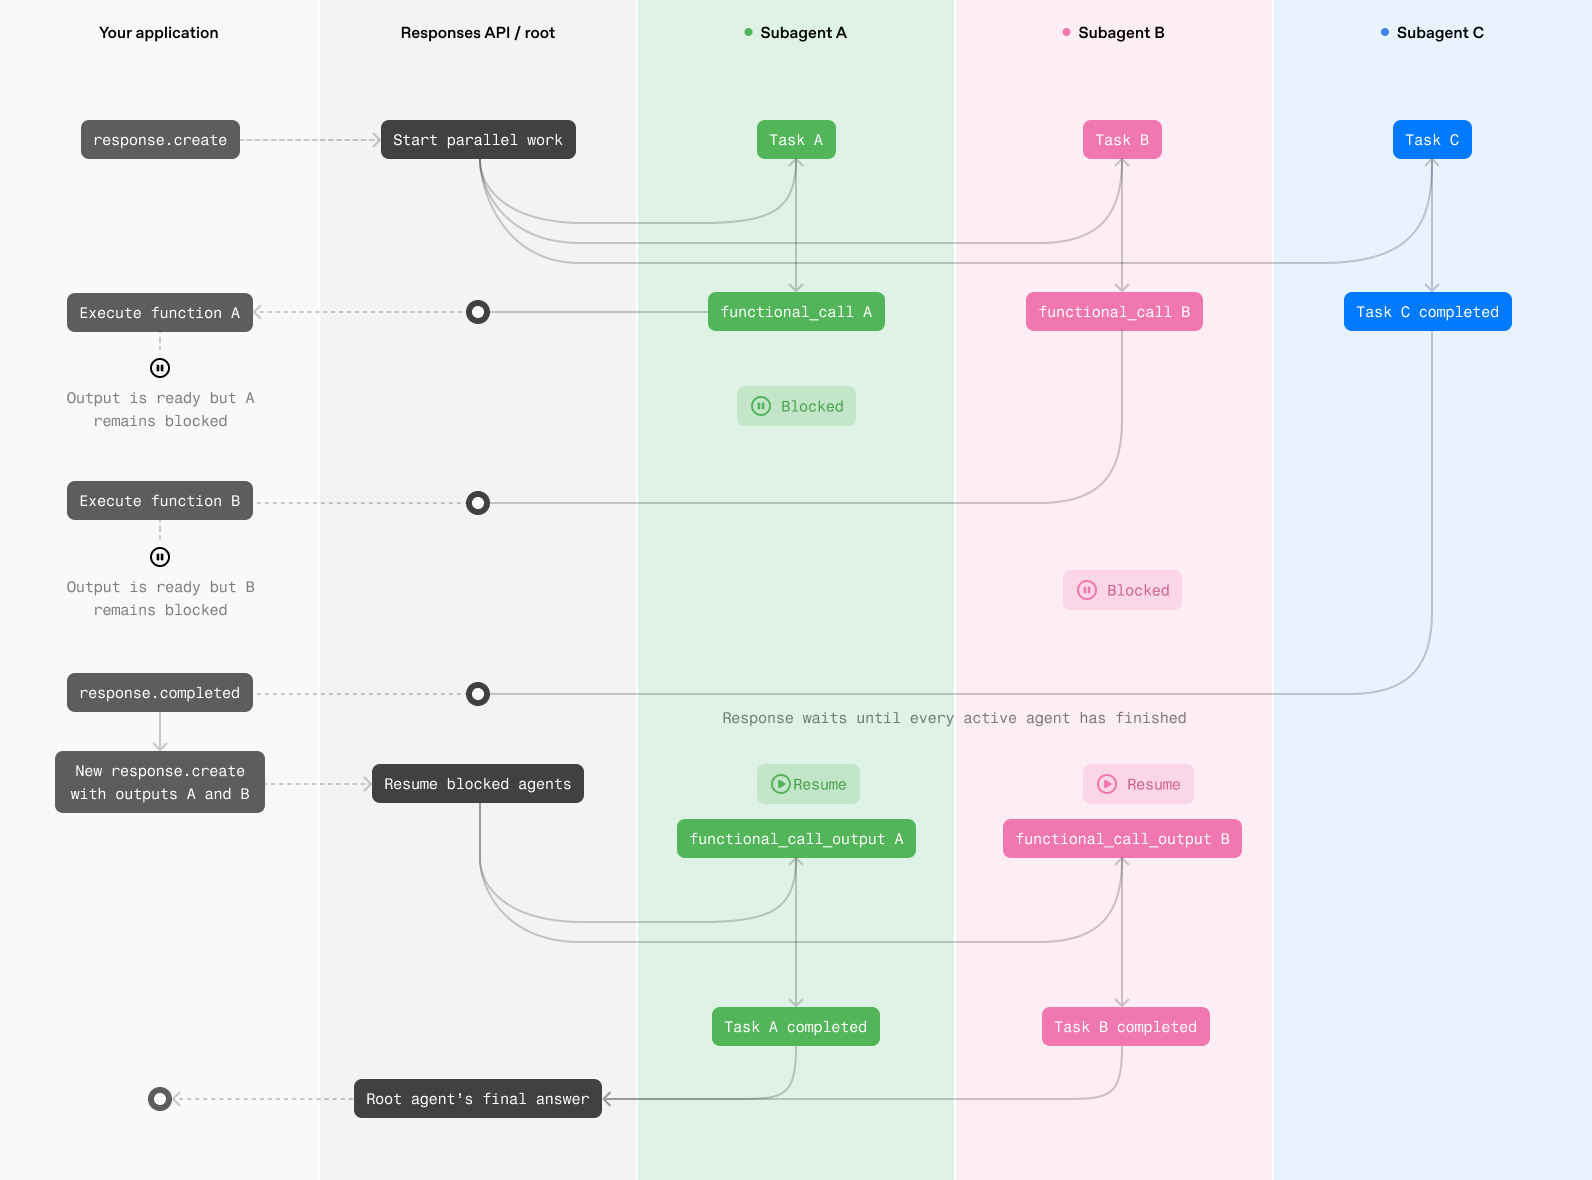
Sol 还支持 Responses API 的 Multi-agent beta。它适合让不同子智能体分别检查代码、文档和测试,再由根智能体汇总。如果多个分支同时改同一个文件,协调成本会增加;需要严格依次执行的流程也不一定适合并行。查看 Multi-agent 用法。选择低一些的推理档位、缩小任务范围并建立明确的检查点,往往比单纯把所有选项拉到最高更实用。
多个智能体怎样配合
继续阅读
GPT-6.1 Sol 发布:使用入口、用法图解与复杂工作指南
延伸阅读:Responses API 多智能体实战
OpenAI 多智能体实战:用 Responses API 拆任务、接工具与优化并行流程 — 从 GPT-6.1 Sol 的代码审查示例开始,了解任务委派、业务工具接入与 HTTP / WebSocket 的区别。
