
Humata
效率办公通过带来源的回答检索、总结和比较上传文档。Humata 提供团队文档访问功能,并以页数额度支持持续知识工作。
跨文件提问引用段落
面向开发者的免费 OCR 推理工具,可将图片转换为文字、文字框和置信度,适合集成到文档处理、搜索索引和桌面应用。支持本地运行及多种推理后端,具体语言与效果由模型决定。
RapidOCR 是将文字识别接入软件的推理工具包。它识别图片中的文字并提供程序可读取的结果,适合将 OCR 作为文档自动化的一环,而不是每次都由人工打开桌面软件复制结果。
项目使用识别模型并支持多种推理运行时,与 PaddleOCR 生态存在模型来源及转换关系;Umi-OCR 等软件则可以在引擎上提供图形界面。三者分别偏向模型生态、推理组件和用户应用,用途不同,不应只因都能识别文字就视为同一个产品。
建立截图搜索索引
为知识库准备资料
制作人工复核队列
集成桌面辅助工具
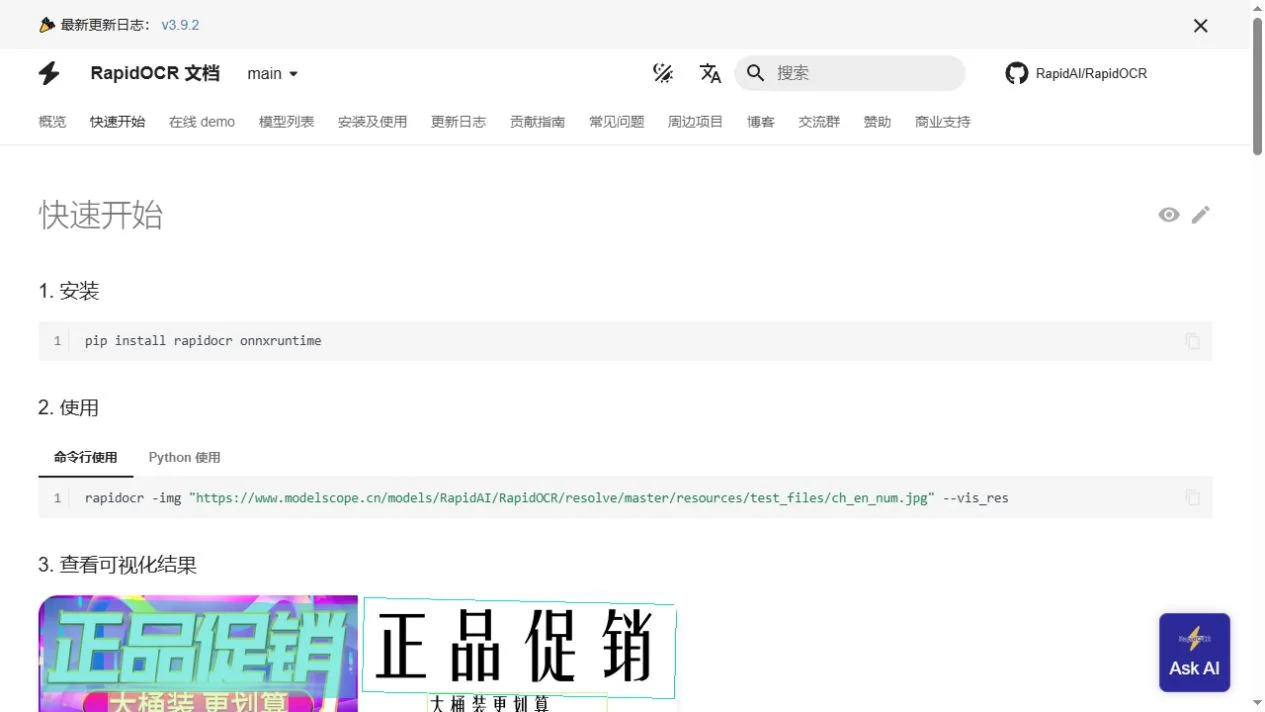
官方图片,可点击放大查看。
确定部署环境
运行官方样例
评估自己的图片
保留处理来源
示例提示或操作任务:为图片型参考资料建立本地 OCR 步骤,保存页码、文字、坐标和置信度;有疑问的金额或编号先进入人工复核,再写入可搜索索引。
以上为编辑建议流程,并非本站性能实测。
RapidOCR 以 Apache-2.0 许可开源,本地运行不要求订阅按图片收费的云 OCR 服务。但处理器、内存、存储以及对外提供服务的基础设施,都仍由使用者自行承担。
RapidOCR 以 Apache-2.0 许可开源,本地运行不要求订阅按图片收费的云 OCR 服务。但处理器、内存、存储以及对外提供服务的基础设施,都仍由使用者自行承担。
应用分发前还需检查具体模型、字体和依赖组件的许可。工具包源代码采用一种开源许可,并不自动替代上游模型及其他附带资源各自的使用与分发条件。
源代码采用 Apache-2.0 许可,可按许可要求使用。
不一定,官方有支持 CPU 的推理路线,是否加速应根据任务选择。
可以,但运行时、模型及其他所需资源必须已经在本地准备好。
当前文档展示包含 boxes、txts、scores 等信息的结果对象。
不能这样理解,语言覆盖取决于具体识别模型。
不是,RapidOCR 主要提供可集成的引擎,Umi-OCR 提供面向用户的桌面界面。
重要数字和字段仍应对照原件,置信度不能直接作为正确性保证。
平台、输入输出、开源许可和使用条件,完整保留在这里。
官方安装指南列出平台、Python 环境和不同运行时的接入要求。小型 CPU 部署与显卡加速服务可能使用不同的软件包、模型格式和资源设置,应按实际路线配置。
文字识别不等于完整文档理解。多栏顺序、表格单元格、数学公式和手写笔记可能需要额外处理,应把 OCR 与后续解析之间的输入输出定义清楚,让每一阶段都能够单独检查和改进。
本地部署可让识别输入留在自己的环境内。如果进一步封装成服务,应按实际资料设置访问控制、输入限制和日志保存策略,避免把内部文档内容意外写入公开日志。
官方演示图片只说明使用方式,不代表已经在你的业务资料上验证效果。应使用有权处理的样例评估,并保留原始文档用于纠错,不要静默地用识别文本替换唯一原件。
正在加载使用体验…
收藏仅自己可见。评论通过审核后公开,修改后会重新审核;评论数量包含获准公开的评论和回复。每人一份评分,新评分自动批准,撤回、未获批准或失效的评分不计入总分。请分享真实体验,避免垃圾信息、私人信息或人身攻击。
审核申诉或数据处理问题: support@findgoodai.com
带上一个真实任务,看看它是否适合你的工作方式。
使用体验