
2026 年 9 月 15 日,TypeSafe AI 发布 Jev,并开放早期访问。这个模型值得关注的地方,是把 AI 接口缩成软件可以调用的一组决策:给出当前情境,列出有限问题,拿回有类型的结果。发布文章 提出了 System One 模型的方向。下面结合发布图表与开发文档,把它能做什么、第一步怎样运行,以及图里的成绩该如何理解说清楚。
为什么“判断”可以单独成为一种模型
许多软件动作最终只需要一个有限答案。客服系统要知道请求属于哪一类;搜索系统要知道哪个段落更相关;工具站需要知道用户在找视频生成器还是图片编辑器。为了得到这个答案,先让聊天模型生成一段解释,再从解释里提取 JSON,应用就多了一层输出解析和检查。把判断本身做成接口,开发者可以直接读取字段,也可以在同一个输入上问几个独立问题。
我更看重它对产品设计的影响。过去做“聪明一点的筛选”常常会发展成一个大聊天框,而聊天框又要求会话、长回答和额外提示。对于用途明确的页面,其实一次分类加一句追问已经够用。模型只负责判断,页面仍然沿用原来的搜索和筛选方式,用户不用学习新的操作习惯。这类细小的改进适合先验证,也容易观察是否真正减少了无效点击。
第一张图:成本优势从哪里看,不能从哪里推
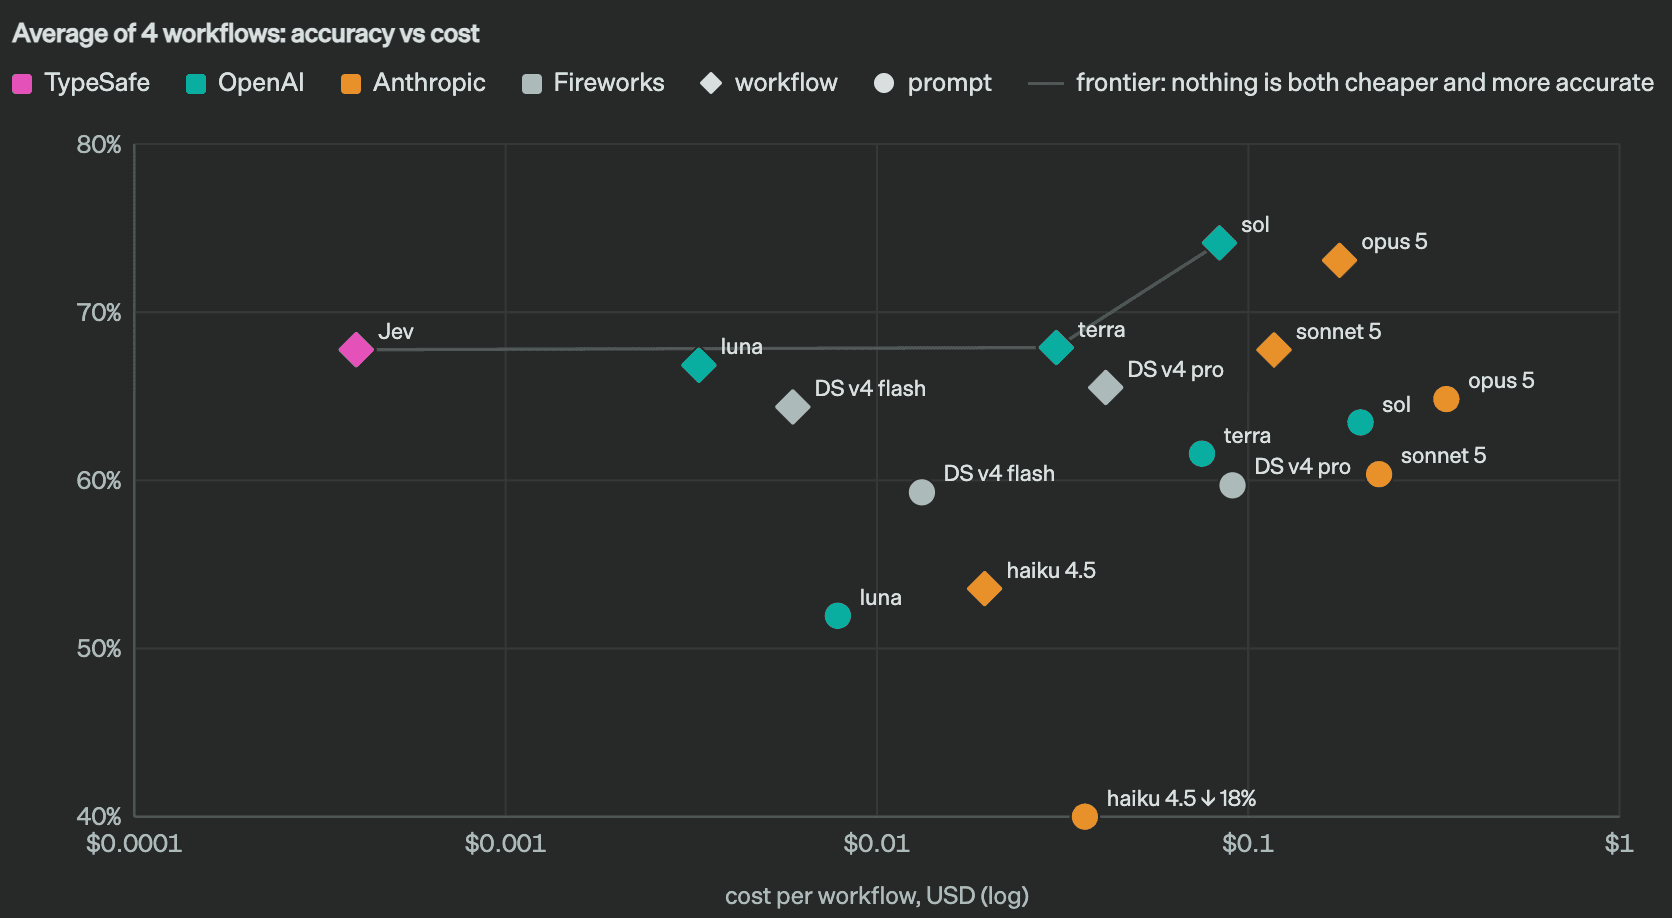
横轴是单次工作流美元成本,采用对数刻度;纵轴是四类工作流平均表现。读这种图时,先比较同类标记:菱形对应分解后的工作流,圆形对应整段提示。向左和向上都更有利,但两点之间的横向距离不是简单的美元差。官方评测说明 表明,参考答案来自较强模型的共识,评测范围是四个固定工作流。它测的是这些条件下的表现,不是所有任务的客观正确率。
如果你正在选择一个分类层,值得把这张图转化成自己的问题:一天处理多少条、每条包含多少文本、错误之后需要多少人工返工、慢一次会不会影响用户操作。输入成本很低而返工成本很高的业务,准确率提升通常比再省一点 token 更有价值。反过来,只做只读标签推荐时,可以接受更多不确定结果,让用户最终选择。比较预算时,把人工复核和失败重试也计入总成本,才接近产品实际。
第二张图:工作流不等于把一切写进提示词
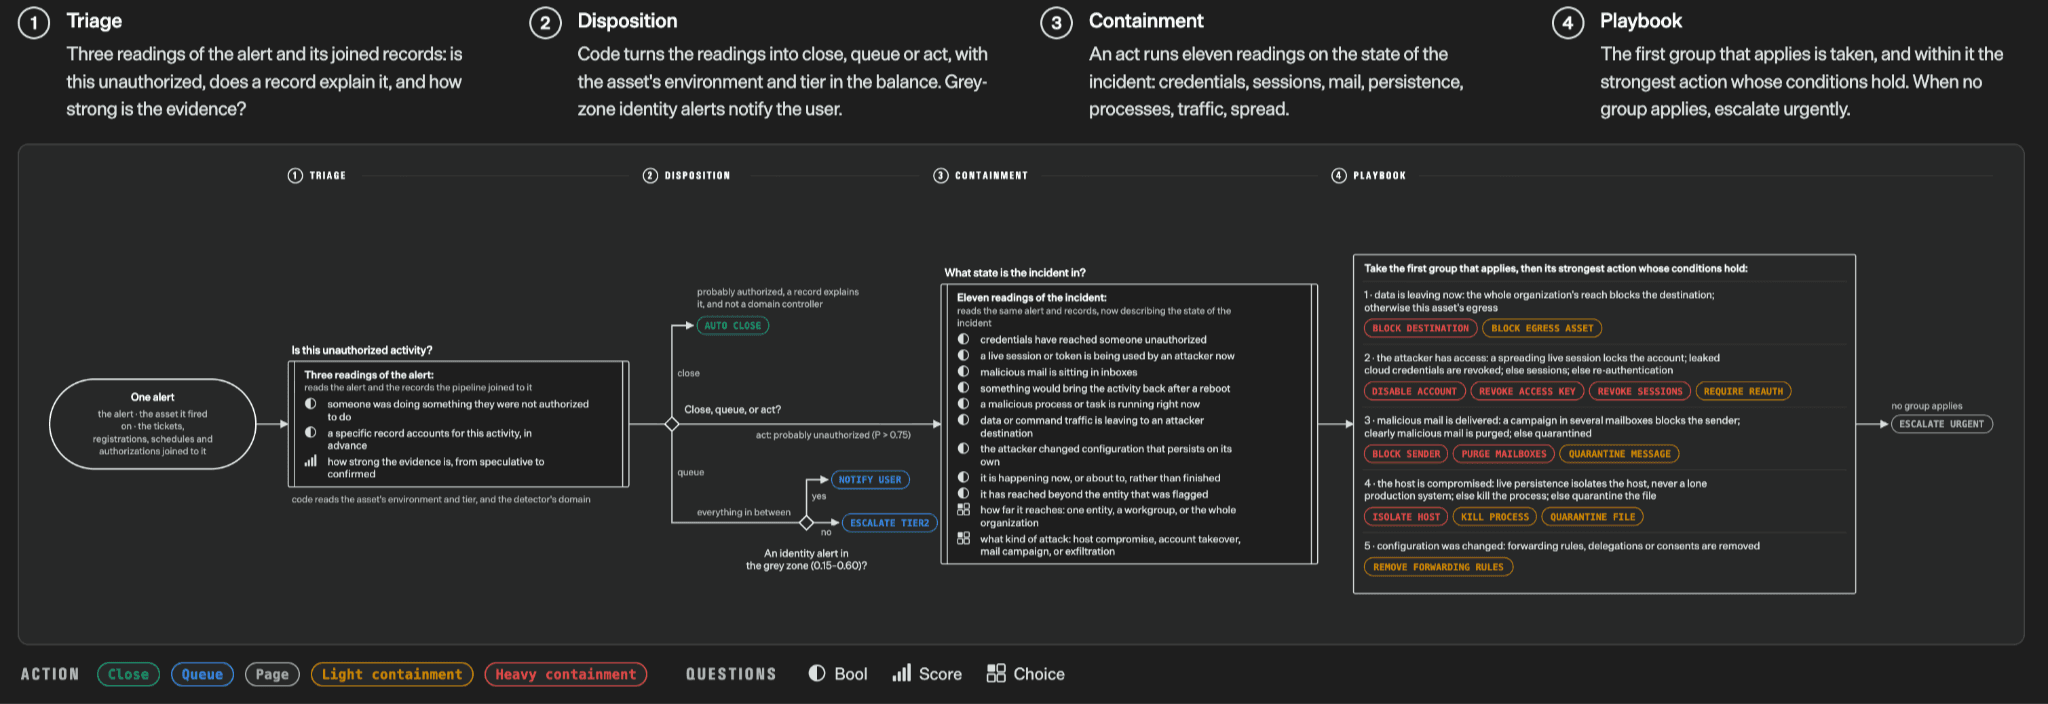
图中的安全告警示例分成初步判断、处置、遏制与执行预案。可以观察到,问题框和行动框承担不同任务:问题判断当前情况,代码再依据规则选择下一步。四类工作流案例 还提供智能体运行观察、发票处理和客户服务。这里真正有参考价值的是拆解方式,而不只是模型名字。
把这个思路迁移到工具目录,可以先用代码验证链接和价格字段是否存在,再问内容是否符合某个用途。检索完成后,对候选工具做相关性判断,最后用普通排序和页面组件呈现。每一层有各自可检查的输入和输出:网址无效是数据问题,分类错了是题目或模型问题,排序不合适是产品规则问题。分清这些责任,才能避免“效果不行就换一个更大模型”的反复试错。
第三张图:“零格式错误”与“零判断错误”是两件事

这张图比较的是结构化输出和工具调用的格式错误。发布文章说明,Jev 的零值建立在输出结构被限定这一性质上,而不是证明世界上每个判断都正确。一个 Choice 可以始终返回合法类别,也仍然可能选错类别。文章讨论 “hallucination” 时,读者要注意这里涉及的输出定义。发布文中的说明 与 已知问题清单 应当一起读。
对于使用者,容易忽略的错误往往是“看起来完全合法”。一条图片需求被分成视频,字段齐全,后端没有报错,用户却看到了错误结果。因此我会把格式验证与内容验证分开统计:前者看 schema,后者用人工标签或业务反馈判断。两种指标分开之后,便能知道工具解决了哪个问题,以及还有哪个问题需要靠题目设计或产品规则补齐。
不用写代码,先在 Playground 做一次判断
打开 TypeSafe Playground,登录后把一条文本放入 state。可以用自己的工具需求,比如“我有一张商品照片,要去掉背景,放到店铺里”。接着添加 Choice 问题:这项工作应该交给 image、video、coding 还是 manual?给各选项写一句明确说明,而不是只有短标签。运行后看选中项,再看概率是否集中。
第二次不要继续用相似的简单样例,换成“我想制作商品展示内容”,看看信息不足时会怎样。第三次试“帮我写一个自动处理商品照片的脚本”,这个请求同时带有图像与编码词。若你希望它按最终交付物而非关键词分类,就在 instructions 里写清楚“选择完成所述交付物的处理器”。随后保留不属于任何候选项的输入,观察 manual 是否能接住。这个小实验的重点是检查问题定义,而不是追求每次都显示最高置信度。
用 Python 接入:一次请求问三个小问题
按照 Python SDK 文档 安装 typesafe-sdk,并在服务端配置 TYPESAFE_API_KEY。下面是为工具目录写的接入示例,使用官方 SDK 的类型与方法,样例数据和题目由本文另写。它展示分类、描述完整度和是否需要已有图片三个独立判断;示例没有预填模型的实际回答,也没有在发布本文时调用付费 API。
python -m pip install typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient
state = {
"message": "I need an AI tool to remove a photo background for a shop listing.",
"available_handlers": ["image", "video", "coding", "manual"],
}
with TypeSafeClient() as client:
response = client.system_one(
model="jev-1.13.0",
state=state,
questions={
"handler": Choice(
instructions="Which handler fits the requested work?",
criteria={
"image": "Create or edit a still image, including removing a background",
"video": "Create, edit, or understand a moving video",
"coding": "Write or debug software",
"manual": "The request is unclear or none of these handlers fits",
},
),
"detail": Score(
instructions="How clearly is the desired outcome described?",
criteria=[
"No concrete task is stated",
"A task is stated but the desired result is unclear",
"The task and intended use are explicitly stated",
],
),
"needs_existing_image": Noul(
instructions="Does this request require editing an existing image?"
),
},
)
handler = response.answers["handler"]
print(response.model)
print(handler.choice, handler.probabilities, handler.confidence)
print(response.answers["detail"].score)
print(response.answers["needs_existing_image"].noul)
# Illustrative starting policy, to be tuned against labeled examples.
if handler.choice == "manual" or handler.confidence < 0.8:
print("Ask the user to clarify")
else:
print("Show tools in category:", handler.choice)运行后先读 response.model,确认是哪一个版本处理了请求。再读 handler 的 choice、probabilities 和 confidence。detail 的 score 对应你在 criteria 中写出的等级位置;needs_existing_image 的 noul 则是命题为真的概率。Score 与 Noul 的含义不同,不要把一个 0.8 的 Noul 解释成“图片处理难度 80 分”。
示例最后的 0.8 是演示策略,不是所有业务通用阈值。对于目录推荐,低置信度时可以追问一次;对于内部工单,可能进入人工队列。你的行动成本不同,分界就应该不同。不要为了让自动处理比例好看而强行把阈值调低:应记录多少条减少了操作、多少条被误分、多少条需要回退。这样的记录比某个单独阈值更能解释上线后的效果。
把多个问题放在一起,减少不必要的往返
同一条输入需要几种判断时,可以在一次 questions 中提交多题;并行问题模式 介绍了这一方式。对工具目录,类别、是否需要现有素材、是否需要代码环境可以分别问。然后代码只读取当前页面用得上的答案。额外题目仍然增加输入 tokens,题目不应为了“多问一点总没坏处”无止境增长。
我会先写出真正影响页面行为的字段,再倒推题目。比如用户只是在看工具推荐,是否需要上传素材会改变入口说明,是否愿意编程会改变候选工具,因此值得问。至于用户有没有商业计划,如果不会改变当前搜索结果,就没必要在这个阶段加入。明确每个字段的用途,既能控制请求长度,也能让调试时知道某个问题为什么存在。
搜索重排:让相关答案往前,而不是重新生成一份资料
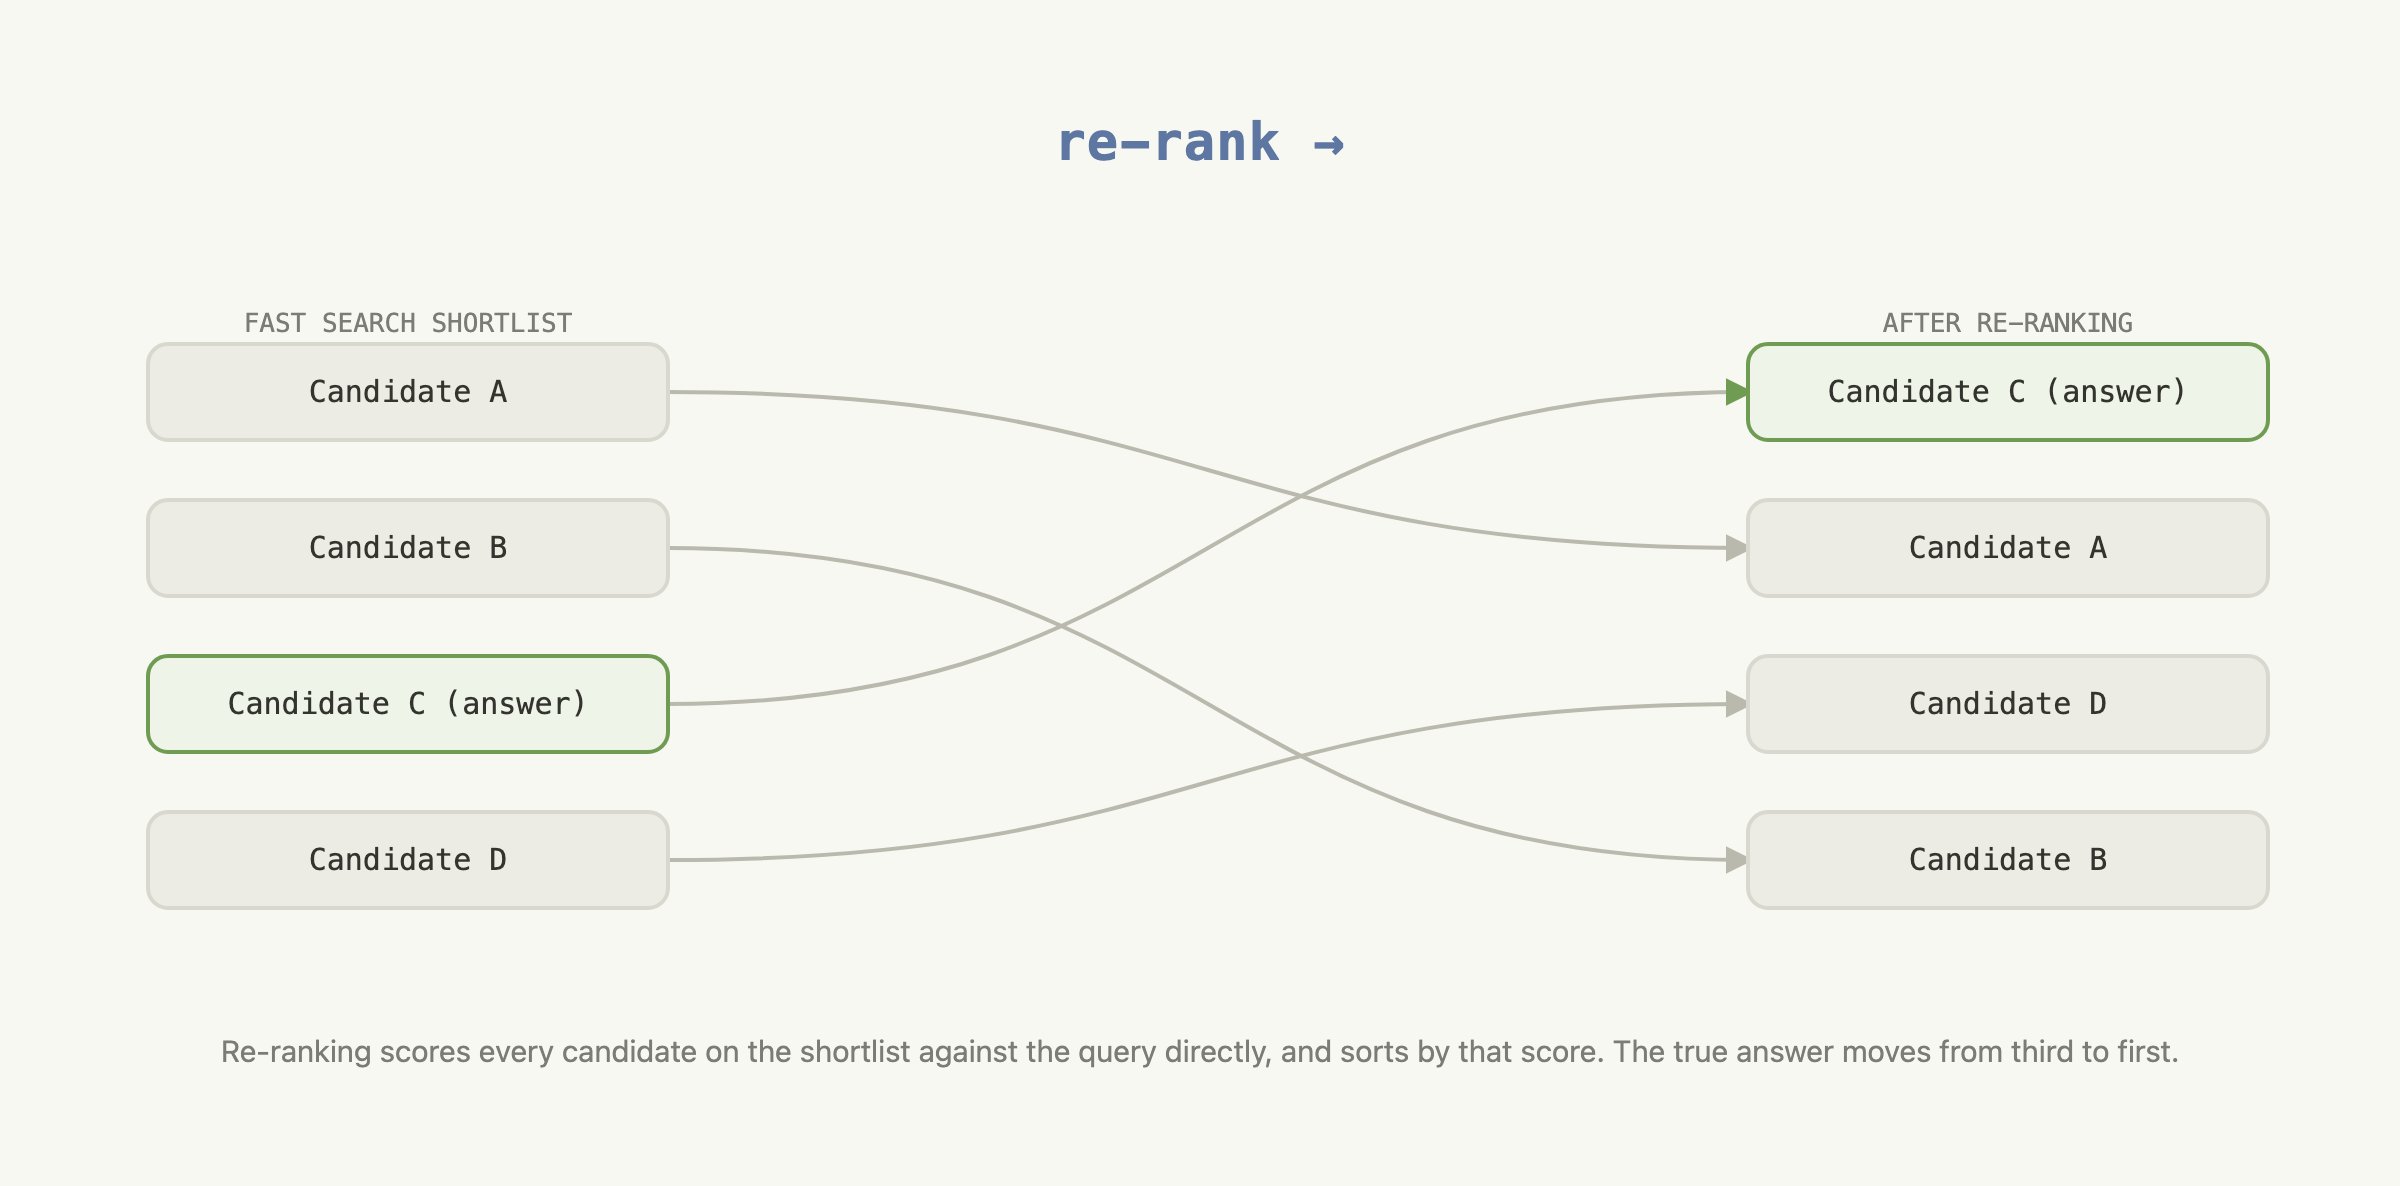
重排的输入是已经检索出的候选项,输出是新的顺序。图中的正确答案原本位于候选列表中部,评分后移到前面。对于工具目录,第一层仍然可以用关键词、类别和向量搜索找候选;第二层才逐个判断候选是否真正解决用户需求。官方重排教程 展示了这种两步结构。
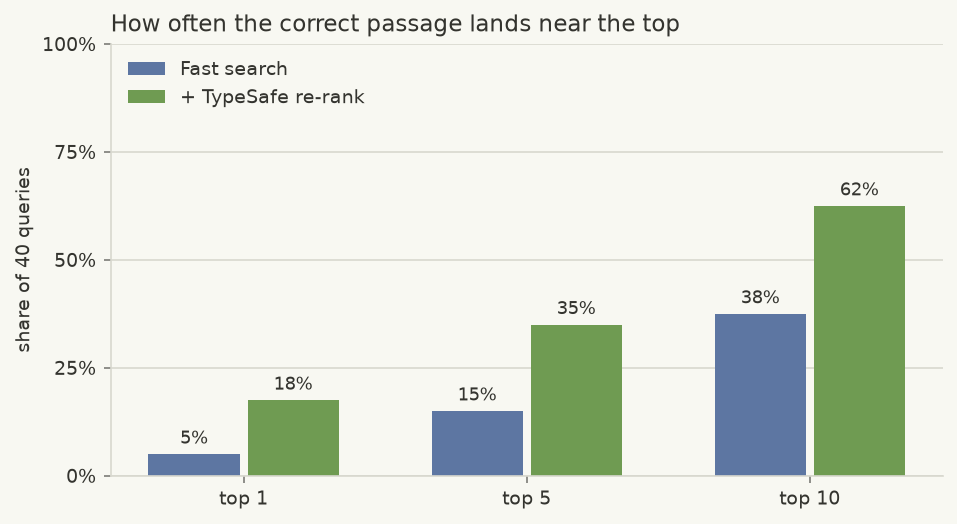
教程用 40 个 CLERC 查询进行演示,top 1 命中率由 5% 到 18%,top 10 由 38% 到 62%。图表来自教程记录的旧版 Jev 1.12 运行,不是我们对当前 1.13 的独立测试;这个小样本也不能证明所有检索任务都有同样提升。拿到自己的资料时,应先确保检索候选里包含正确答案,再比较重排前后的位置。候选阶段漏掉的文档,重排没有办法凭空补出来。
具体到 FindGoodAI,如果用户找“可以批量去背景的工具”,一个标题里写着“AI 图像”但只有文生图的条目不应排在最前。可以让评分问题关注是否支持“已有图片”“去背景”“批量处理”,并把候选介绍和功能字段一并送入 state。结果仍然显示原始工具链接与功能资料,模型只改变候选的次序。这样用户可以核对功能,维护人员也能检查某个排名变化究竟基于什么信息。
引用核对和编码技能还有哪些用途
在 引用核对案例 中,普通字符串匹配先检查引文是否存在,模型再判断上下文是否支持说法。这种拆分很适合内容站:不存在的原句不需要模型判断,已经存在的原句也未必能支撑作者的结论。可以把每个关键论点和来源段落配对,检查支持、矛盾或无关,最终由编辑复核模糊项。
如果你让编码智能体编写 Jev 集成,可使用 TypeSafe 官方技能 提供接口资料。编码智能体说明 明确指出,Jev 并不能直接替换 Claude Code、Codex 或类似工具内部负责生成文字与代码的模型。实际关系是:编码智能体帮助写应用,应用再调用 Jev 执行有限判断。下载 SDK 或安装技能,也不等于把模型权重装到了本机。
真正开始做项目时,我会先验证这几个结果
先准备一批真实需求,给每条需求写出期望分类,再单独留出一部分不用于改题目。测试记录保存原文、版本、题目版本、概率和最终动作。每次修改选项后,在留出的样例上重新比较,避免只把已经看过的错误“修好”。同时加入空输入、混合用途、拼写错误、中文行业词和刻意要求模型选错类别的文本。
应用层至少保留一个可解释的退路:类别不明确就追问,找不到资料就提示没有可靠候选,接口超时就使用原来的搜索方式。若 Jev 能让用户更快找到有效结果,就逐步扩大使用位置;若它增加了更多追问或把常见需求分错,则先修改题目和输入资料。它的价值应当落在完成率、相关性和响应时间这些具体结果上,而不是页面多了一个模型名字。
模型参数和调用入口可以继续查看 FindGoodAI Jev 模型页;扩展资源见 ToolAI Jev 专题。